Agent开发 · 文章
翻译图解 GPT-2(可视化 Transformer 语言模型)
版权与来源
原作品著作权归原作者或相关权利人所有。本译文由本站完成,译文相关权利的行使仍受原作品授权条款约束。
今年,我们见证了机器学习领域一个令人眼花缭乱的应用。OpenAI 的 GPT-2 展现出了令人印象深刻的能力——能够写出连贯而有感染力的文章,其水平超出了我们对当前语言模型的预期。GPT-2 本身并不是一个特别新颖的架构——它的架构与"仅解码器"的 Transformer 非常相似。然而,GPT-2 是一个非常庞大的、基于 Transformer 的语言模型,在海量数据集上训练而成。本文将深入探讨使该模型能够产生其成果的架构,深入剖析其自注意力层,并研究"仅解码器" Transformer 在语言建模之外的应用。
我的目标还在于补充我此前的文章《图解 Transformer》,用更多可视化内容来解释 Transformer 的内部工作原理,以及它们自原始论文以来的演变历程。希望这套视觉语言能让解释后续 Transformer 模型变得更加容易。
第一部分:GPT-2与语言模型
那么,语言模型究竟是什么?
什么是语言模型
在《图解 Word2vec》中,我们探讨了什么语言模型。
本质上就是一种能够观察句子的一部分并预测下一个词的机器学习模型。广为人知的语言模型就是智能手机的键盘,它根据你当前的输入来建议下一个词。
Pasted image 20260503110428.png
从这个意义上讲,GPT-2基本上就是键盘应用的下一个词预测,只不过比你手机上的版本大得多、复杂得多。GPT-2在一个名为WebText的40GB数据集上训练,改数据集是OpenAI研究人员作为研究工作从网上爬去的一部分。
对比来看,我使用的键盘应用SwiftKey只占78MB内存空间,而最小版本的训练好的GPT-2就需要500MB来存储其所有参数。最大版本是最小版本的13倍,可能需要超过6.5GB的存储空间。
Pasted image 20260503110436.png
体验GPT-2的一个好方法是使用AllenAI GPT-2 Explorer。它使用 GPT-2 显示下一个词的十个可能预测(以及概率得分)。你可以选择一个词,然后看到下一批预测,从而继续续写文章。
用 Transformer 做语言建模
正如我们在《图解 Transformer》中看到的,原始 Transformer 模型由一个编码器和一个解码器组成——每个都是由若干"Transformer 块"堆叠而成。这种架构适合机器翻译任务,因为编码器-解码器架构在该任务上历来表现出色。
Pasted image 20260503110540.png
此后大量研究工作对这一架构进行了简化,要么舍弃编码器,要么舍弃解码器,只使用一个 Transformer 块的堆栈——尽可能地往高叠,喂给它海量的训练文本,再投入庞大的计算资源(训练某些语言模型耗资数十万美元,AlphaStar 这类模型估计要耗资数百万美元)。
Pasted image 20260503110533.png
这些块能叠多高?这正是区分不同 GPT-2 模型大小的主要因素之一:
Pasted image 20260503110610.png
与 BERT 的一个关键区别
机器人第一定律:机器人不得伤害人类,或因不作为而使人类受到伤害。
GPT-2使用Transformer的解码器块构建,而BERT使用Transformer的编码器块。我们将在后续的章节中详细说明区别。但两者之间有一个关键区别:GPT-2 与传统语言模型一样,每次输出一个 token。举个例子,假设我们让一个训练好的 GPT-2 来背诵机器人第一定律:
gpt-2-output 1.gif
这些模型的实际工作方式是:每生成一个token,该token就倍添加到输入序列中,这个新的序列称为模型下一步的输入。这种思路被称为 自回归(auto-regression),也是使RNN出乎意料的有效思想之一。
gpt-2-autoregression-2.gif
GPT-2以及后来的一些模型,比如TransformerXL和XLNet,本质上都是自回归。 BERT则不是,这是一种权衡:失去自回归能力的同时,BERT获得了结合词语两侧上下文的能力,从而获得更好的结果。XLNet则找到了一种替代方式,在恢复自回归的同时也融合两侧上下文。
Transformer 块的演变
编码器块
Pasted image 20260503123843.png
原始 Transformer 论文中的编码器块可以接受一定最大序列长度(例如 512 个 token)的输入。如果输入序列比这个限制短,可以用填充(padding)补足。
解码器块
第二种是解码器块,他与编码器有一个细微的架构差异.那就是多了一层,用于关注来自编码器的特定片段。
Pasted image 20260503124018.png
自注意力层的一个关键区别在于,它遮蔽(mask)了未来的 token——不是像 BERT 那样将词替换为 [mask],而是在自注意力计算中干预,阻止来自当前计算位置右侧 token 的信息流入。
Pasted image 20260503124115.png
例如,如果我们追踪位置 #4 的路径,可以看到它只被允许关注当前位置及之前的 token:
明确区分自注意力(BERT 使用)和掩码自注意力(GPT-2 使用)非常重要。普通的自注意力块允许一个位置"偷看"其右侧的 token,而掩码自注意力则防止这种情况发生:
Pasted image 20260503124201.png
仅解码器块
在原始论文发表之后,《通过摘要长序列来生成维基百科》一文提出了另一种 Transformer 块的排列方式,能够进行语言建模。这个模型抛弃了编码器,让我们将其称为"Transformer-Decoder"。这个早期的基于 Transformer 的语言模型由六个 Transformer 解码器块堆叠而成:
Pasted image 20260503153456.png
这些解码器彼此相同。 我展开了第一个块,你可以看到它的自注意力层是掩码版本。注意,这个模型现在可以处理某个片段中长达4000个token的序列,相比原始Transformer的512个是巨大的提升。
类似的架构在《基于更深自注意力的字符级语言建模》中也有研究,用于构建逐字符预测的语言模型。
OpenAI 的 GPT-2 使用的正是这些仅解码器块。
脑外科速成课:深入GPT-2内部
向内看,你就会发现, 那些话语正深深刺入我的脑海。 烈焰灼烧,迅速燃烧, 文字之刃正将我逼向疯狂,疯狂啊。 ~Budgie
让我们把一个训练好的GPT2放在手术台上,看看他是如何工作的。
Pasted image 20260503154216.png
GPT-2 可以处理 1024 个 token。每个 token 沿着自己的路径依次流过所有的解码器块。
运行训练好的 GPT-2 最简单的方式,是让它自由发挥(技术上称为"生成无条件样本")——或者,我们也可以给它一个提示,让它围绕某个主题来说(即生成"交互式条件样本")。在自由发挥的情况下,我们只需给它起始 token,让它开始生成词语(训练好的模型使用 <|endoftext|> 作为起始 token,我们简称它为 <s>)。
Pasted image 20260503154224.png
这时模型只有一个输入 token,所以只有一条路径是激活的。这个 token 依次通过所有层处理,沿该路径产生一个向量。这个向量可以与模型词汇表(GPT-2 知道的所有词,共 50,000 个词)进行打分对比。在本例中,我们选择了概率最高的 token——"the"。当然,我们也可以引入一些随机性——就像你在键盘应用中一直点推荐词,有时会陷入重复循环,只有点第二或第三个推荐词才能跳出来。这里同样如此。GPT-2 有一个 top-k 参数,可以让模型考虑对概率前 k 名的词进行采样(当 top-k = 1 时,即始终选最高概率的词)。
在下一步,我们将第一步的输出添加到输入序列中,让模型做出下一个预测:
Pasted image 20260503154358.png
注意,第二条路径是这次计算中唯一激活的路径。GPT-2 的每一层都保留了对第一个 token 的理解,并在处理第二个 token 时加以利用(我们将在后面关于自注意力的章节中详细介绍)。GPT-2 不会根据第二个 token 重新解释第一个 token。
更深入的探索
输入编码
让我们深入了解更多细节,更深入地认识这个模型。先从输入开始。和我们之前讨论过的其他 NLP 模型一样,模型会在嵌入矩阵中查找输入词的嵌入——这是训练好的模型的组成部分之一。
Pasted image 20260503155059.png
每一行都是一个词嵌入:一组代表该词并捕捉其部分含义的数字。这组数字的长度在不同 GPT-2 模型规模中有所不同。最小的模型对每个词/token 使用 768 维的嵌入。
因此,一开始,我们在嵌入矩阵中查找起始 token <s> 的嵌入。在将其传入模型的第一个块之前,我们还需要融入位置编码——一种向 Transformer 块指示序列中词语顺序的信号。训练好的模型包含一个矩阵,其中存储了输入中 1024 个位置各自对应的位置编码向量。
Pasted image 20260503155135.png
至此,我们了解了输入词语在被传入第一个 Transformer 块之前是如何处理的,也认识了构成训练好的 GPT-2 的两个权重矩阵。
将一个词送入第一个 Transformer 块,意味着查找其嵌入,再加上位置 #1 的位置编码向量。
Pasted image 20260503155158.png
沿堆栈向上的旅程
第一个块现在可以处理这个 token 了:首先经过自注意力过程,然后通过其神经网络层。一旦第一个 Transformer 块处理完这个 token,它就将结果向量向上传递,由下一个块继续处理。每个块的处理过程完全相同,但每个块在自注意力和神经网络子层中都有自己独立的权重。
自注意力回顾
语言很大程度上依赖于上下文。例如,看看这条第二定律:
机器人第二定律 机器人必须服从人类给予它的命令,除非这些命令与第一定律相冲突。
我在句子中高亮了三处——这些词都在指代其他词。如果不结合它们所指代的上下文,根本无法理解或处理这些词。当模型处理这个句子时,它必须能够知道:
"它" 指的是机器人
"这些命令" 指的是该定律前面的部分,即"人类给予它的命令"
"第一定律" 指的是整个第一定律
这正是自注意力的作用。它在将某个词传入神经网络处理之前,就将模型对相关词语的理解"融烤"进去。具体做法是:对片段中每个词的相关程度进行打分,然后将它们的向量表示加权求和。
举例来说,顶层块中的自注意力层在处理单词 "it" 时,正在关注 "a robot"。它传给神经网络的向量,是三个词各自的向量乘以其得分后的总和。
Pasted image 20260503155313.png
自注意力处理过程
自注意力沿片段中每个 token 的路径进行处理。核心组件是三个向量:
查询(Query):查询是当前词的表示,用于与所有其他词(通过它们的键)进行打分。我们只关心当前正在处理的 token 的查询。
键(Key):键向量就像片段中所有词的标签,是我们在搜索相关词时进行匹配的对象。
值(Value):值向量是词的实际表示。一旦我们对每个词的相关程度打好分,这些就是我们加权求和以表示当前词的向量。
Pasted image 20260503155450.png
一个粗略的类比是把它想象成在档案柜里搜索资料。查询就像一张写着你研究课题的便利贴,键就像档案柜里各文件夹的标签。当你把便利贴与标签匹配上时,就取出那个文件夹的内容,这些内容就是值向量。不过你不是只找一个值,而是从多个文件夹混合取出内容。
将查询向量与每个键向量相乘,就会产生对每个"文件夹"的打分(技术上:点积后接 softmax)。
Pasted image 20260503155507.png
我们将每个值乘以其得分并求和——得到自注意力的结果。
Pasted image 20260503155529.png
这个加权混合的值向量结果,使得 50% 的"注意力"落在词 robot 上,30% 落在词 a 上,19% 落在词 it 上。文章后面我们还会深入探讨自注意力机制,但现在让我们继续沿堆栈向上走,直到模型的输出。
模型输出
当模型中最顶层的块产生其输出向量(即经过自身自注意力和自身神经网络的结果)之后,模型将该向量与嵌入矩阵相乘。
Pasted image 20260503155752.png
回想一下,嵌入矩阵的每一行对应模型词汇表中某个词的嵌入。这次乘法的结果被解释为模型词汇表中每个词的得分。
Pasted image 20260503155816.png
我们可以直接选择得分最高的 token(top_k = 1)。但如果让模型同时考虑其他词,通常能获得更好的结果。所以更好的策略是:将得分作为选择每个词的概率,从整个列表中进行采样(得分越高,被选中的概率越大)。一种折中方案是将 top_k 设为 40,让模型只从得分最高的 40 个词中考虑。
Pasted image 20260503155832.png
至此,模型完成了一次迭代,输出了一个词。模型持续迭代,直到生成完整的上下文(1024 个 token),或者产生序列结束 token 为止。
第一部分小结
好了,以上就是 GPT-2 工作方式的概述。如果你想确切了解自注意力层内部发生了什么,后面的附加部分正是为你准备的。我创建这部分内容,是为了引入更丰富的视觉语言来描述自注意力,以便将来描述和检视后续的 Transformer 模型(TransformerXL 和 XLNet,我可盯着你们呢)。
在此需要说明本文的几处简化:
我将"词"和"token"交替使用。但实际上,GPT-2 使用字节对编码(Byte Pair Encoding)来创建词汇表中的 token,这意味着 token 通常是词的一部分。
我们展示的例子是 GPT-2 在推理/评估模式下运行,所以它每次只处理一个词。在训练时,模型会针对更长的文本序列进行训练,同时处理多个 token;训练时的批量大小也更大(512),而评估时批量大小为 1。
我为了图像排版方便,对向量进行了旋转/转置处理。在实际实现时,需要更加严谨。
Transformer 大量使用层归一化,这非常重要。我们在《图解 Transformer》中提到了一些,但本文更多聚焦于自注意力。
有时我需要用更多方块来表示一个向量,我将其标注为"放大"。
第二部分:图解自注意力
早些时候,我们在帖子中展示了这张图片,以展示自注意力机制在处理单词 it 的层中的应用:
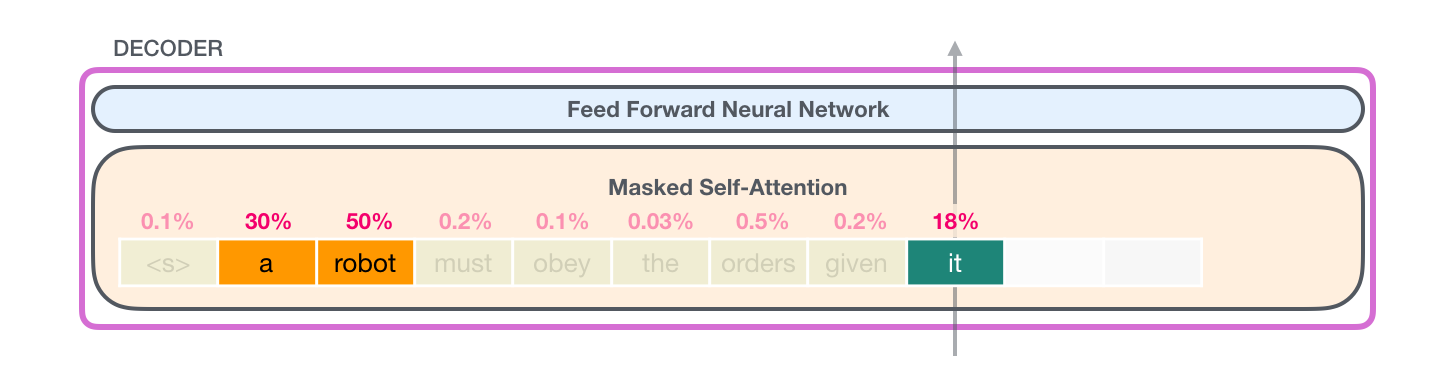
本节我们将详细了解这是如何做到的。注意,我们将尝试从单个词的角度来理解发生了什么,因此会展示很多单个向量。实际实现是通过巨型矩阵乘法完成的,但我想在这里专注于词级别的直觉理解。
自注意力-无掩码
我们先来看看编码器块中计算原始自注意力。假设有一个只能处理四个token的玩具Transformer块。
自注意力跳过三个主要步骤进行:
为每条路径创建查询、键和值向量。
对每个输入 token,用其查询向量与所有其他键向量打分。
将值向量乘以对应得分后求和。
Pasted image 20260503160835.png
1-创建查询、键和值向量
我们聚焦于第一条路径。取其查询向量,与所有键进行比较,为每个键产生一个得分。自注意力的第一步是为每个 token 路径计算三个向量(暂时忽略注意力头):
Pasted image 20260503160840.png
2- 打分
现在我们有了这些向量,在第二步只使用查询向量和键向量。由于我们聚焦于第一个 token,将其查询与所有其他键向量相乘,得到四个 token 各自的得分。
Pasted image 20260503161319.png
3- 求和
现在我们可以将得分乘以值向量了。得分高的值向量在最终求和后将占结果向量的较大比例。
Pasted image 20260503161339.png
得分越低,我们将值向量显示得越透明,以表示乘以一个小数会稀释向量的值。
如果我们对每条路径都执行相同的操作,最终每个 token 都拥有一个包含适当上下文的向量。这些向量随后被传入 Transformer 块的下一个子层(前馈神经网络):
Pasted image 20260503161406.png
自注意力-掩码
我们已经了解了 Transformer 的自注意力步骤,现在来看掩码自注意力。掩码自注意力与自注意力完全相同,只在第 2 步有所不同。假设模型只有两个 token 作为输入,而我们正在观察第二个 token。在这种情况下,最后两个 token 被遮蔽。所以模型会干预打分步骤——它始终将未来 token 的得分置为 0,这样模型就无法"偷看"未来的词:
Pasted image 20260503161726.png
这种掩码通常以一个称为"注意力掩码"的矩阵来实现。想象一个由四个词组成的序列(例如"robot must obey orders")。在语言建模场景中,这个序列分四步被吸收处理——每步处理一个词(暂且假设每个词就是一个 token)。由于这些模型以批量方式工作,我们可以假设批量大小为 4,该玩具模型将整个序列(及其四步)作为一批处理。
Pasted image 20260503161826.png
以矩阵形式,我们通过将查询矩阵与键矩阵相乘来计算得分。可视化如下——每个格子中不是词语本身,而是该词在对应位置的查询(或键)向量:
Pasted image 20260503161917.png
相乘之后,我们叠加注意力掩码三角形,将需要遮蔽的格子设置为负无穷,或一个非常大的负数(GPT-2 中为 -10 亿):
Pasted image 20260503161922.png
然后,对每一行应用 softmax 操作,得到我们在自注意力机制中实际使用的分数:
Pasted image 20260503161945.png
这个得分表的含义如下:
当模型处理数据集中第一个例子(第 1 行),该例子只包含一个词("robot")时,100% 的注意力都集中在该词上。
当模型处理第二个例子(第 2 行),包含词语 "robot must" 时,在处理 "must" 这个词时,48% 的注意力在 "robot" 上,52% 在 "must" 上。
以此类推。
GPT-2的掩码自注意力
让我们更详细地了解 GPT-2 的掩码注意力机制。
评估时:每次处理一个 Token
我们可以让 GPT-2 完全按照掩码自注意力的工作方式运作。但在评估时,模型每次迭代只添加一个新词,这种情况下,对已经处理过的 token 重新计算早期路径的自注意力是低效的。
在此情况下,我们先处理第一个 token(暂时忽略 <s>):
Pasted image 20260503162251.png
GPT-2 保留了 a 这个 token 的键向量和值向量。每个自注意力层都保留着该 token 各自对应的键和值向量:
Pasted image 20260503162325.png
现在在下一次迭代中,当模型处理词 robot 时,它不需要再为 a 这个 token 生成查询、键和值向量了。它直接复用第一次迭代中保存好的那些:
Pasted image 20260503162404.png
GPT-2 自注意力:1- 创建查询、键和值
假设模型正在处理词 it。对于最底层的块,其输入就是 it 的词嵌入加上位置 #9 的位置编码:
Pasted image 20260503162447.png
Transformer 中每个块都有自己的权重(后文会进一步拆解)。我们首先遇到的是用于创建查询、键和值的权重矩阵。
自注意力将其输入与权重矩阵相乘(还要加上一个偏置向量,图中未显示):
Pasted image 20260503162519.png
相乘的结果本质上是词 it 的查询、键和值向量的拼接。
将输入向量与注意力权重向量相乘(并在之后加上偏置向量),就得到了该 token 的键、值和查询向量。
Pasted image 20260503162603.png
GPT-2 自注意力:1.5- 拆分注意力头
在之前的例子中,我们直接跳入了自注意力,忽略了"多头"这部分。现在有必要对这个概念稍加说明。自注意力对 Q、K、V 向量的不同部分执行多次。"拆分"注意力头,实际上只是将长向量重塑为矩阵。小版本的 GPT-2 有 12 个注意力头,所以这就是重塑后矩阵的第一个维度:
Pasted image 20260503162713.png
在之前的例子中,我们观察的是单个注意力头内部发生的事情。理解多头注意力的一种方式如下(如果我们只可视化 12 个注意力头中的三个):
Pasted image 20260503162739.png
GPT-2 自注意力:2- 打分
现在我们可以进行打分了——知道我们只在观察一个注意力头(其他头都在进行类似的操作):
Pasted image 20260503162809.png
现在,这个 token 可以与其他所有 token(在之前迭代中第 1 个注意力头计算得到的那些)的键进行打分:
Pasted image 20260503162837.png
GPT-2 自注意力:3- 求和
和之前一样,我们现在将每个值乘以其得分,然后求和,产生注意力头 #1 的自注意力结果:
Pasted image 20260503162852.png
GPT-2 自注意力:3.5- 合并注意力头
处理多个注意力头的方式是:首先将它们拼接成一个向量:
Pasted image 20260503162906.png
但这个向量还不能直接传入下一个子层。我们需要先将这个"科学怪人拼凑的"隐藏状态转化为一个统一的表示。
GPT-2 自注意力:4- 投影
我们让模型学习如何最优地将拼接后的自注意力结果映射为前馈神经网络可以处理的向量。这里引入第二个大型权重矩阵,它将注意力头的结果投影为自注意力子层的输出向量:
Pasted image 20260503162947.png
有了这个,我们就产生了可以传入下一层的向量:
Pasted image 20260503162956.png
GPT-2 全连接神经网络:第 1 层
全连接神经网络是块在自注意力已将适当上下文融入当前 token 的表示之后,进行处理的地方。它由两层构成。第一层的大小是模型维度的 4 倍(由于 GPT-2 小模型的维度是 768,这个网络将有 768×4 = 3,072 个单元)。为什么是 4 倍?这只是原始 Transformer 采用的大小(模型维度为 512,第一层是 2,048)。这似乎给了 Transformer 模型足够的表示容量,来处理迄今为止被交给它们的各种任务。
Pasted image 20260503163039.png
GPT-2 全连接神经网络:第 2 层——投影回模型维度
第二层将第一层的结果投影回模型维度(小版本 GPT-2 为 768 维)。这次乘法的结果,就是该 token 经过整个 Transformer 块处理后的结果。
你做到了!
这就是我们要深入探讨的最详细版本的 Transformer 块!你现在基本上掌握了 Transformer 语言模型内部发生的事情的绝大部分。总结一下,我们勇敢的输入向量会经历这些权重矩阵:
Pasted image 20260503163121.png
每个块都有一套自己的这些权重。另一方面,模型只有一个 token 嵌入矩阵和一个位置编码矩阵:
Pasted image 20260503163133.png
如果你想查看模型的所有参数,我在这里做了汇总:
Pasted image 20260503163147.png
它们加起来是 1.24 亿个参数,而不是 1.17 亿,原因不详。但公开的代码中似乎就有这么多(如有错误请纠正我)。
第三部分:超越语言模型
仅解码器的 Transformer 在语言建模之外持续展现出令人振奋的潜力。它在很多应用中都取得了成功,可以用与上文类似的可视化方式来描述。让我们用这些应用来结束本文。
机器翻译
进行翻译并不一定需要编码器。仅解码器的 Transformer 同样可以完成这一任务:
Pasted image 20260503163241.png
文章摘要
这正是第一个仅解码器 Transformer 训练的任务。它被训练为:读取一篇维基百科文章(不含目录前的开头部分),然后生成摘要。文章实际的开头部分被用作训练数据集中的标签:
Pasted image 20260503163256.png
该论文将模型训练在维基百科文章上,训练好的模型因此能够对文章进行摘要:
迁移学习
在《使用单个预训练 Transformer 实现高效文本摘要》中,一个仅解码器的 Transformer 先在语言建模任务上进行预训练,再微调以执行摘要任务。研究发现,在数据量有限的情况下,它的效果优于预训练的编码器-解码器 Transformer。
GPT-2 的论文也展示了在语言建模预训练之后进行摘要的结果。
Pasted image 20260503163322.png
音乐生成
Music Transformer 使用仅解码器的 Transformer 来生成具有丰富时间节奏和动态变化的音乐。"音乐建模"就像语言建模一样——让模型以无监督方式学习音乐,然后让它采样输出(即我们之前说的"自由发挥")。
你可能好奇,音乐在这种情况下是如何表示的。回想一下,语言建模可以通过字符、词语或词语片段的向量表示来完成。对于音乐表演(以钢琴为例),我们需要表示音符,还需要表示力度——衡量钢琴键被按压力度的指标。
Pasted image 20260503163330.png
一段表演就是这样一系列 one-hot 向量。MIDI 文件可以转换为这种格式。论文中有以下输入序列示例:
Pasted image 20260503163344.png
该输入序列的 one-hot 向量表示如下所示:
Pasted image 20260503163359.png
我非常喜欢论文中一张展示 Music Transformer 中自注意力的可视化图,我在这里添加了一些注释:
Pasted image 20260503163413.png
这段乐曲有一个反复出现的三角形轮廓。查询位于后面某个峰值处,它关注所有之前的高音峰值,一路回溯到乐曲开头。……图示展示了一个查询(所有注意力线的起点)以及被关注的历史记忆(接收更高 softmax 概率的音符被高亮显示)。注意力线的颜色对应不同的注意力头,线的粗细对应 softmax 概率的权重。"
如果你对这种音符表示方式不太理解,可以观看这个视频。
结语
我们对 GPT-2 的探索之旅,以及对其父模型"仅解码器 Transformer"的深入研究,到此告一段落。希望读完本文后,你对自注意力机制有了更深刻的理解,对 Transformer 内部运行机制也更加从容自信。
参考资源
OpenAI 的 GPT-2 实现
Hugging Face 的 pytorch-transformers 库——实现了 BERT、Transformer-XL、XLNet 等领先 Transformer 模型,除了 GPT-2
版权声明
本文内容版权归作者或相关权利人所有。转载、引用或其他使用请遵循相应授权条款,并保留本文链接。