Agent开发 · 文章
+ 有更新RAG技术解析:如何让AI基于私有知识库进行精准推理
- 在这个实际的操作中,我们会使用RAG读取本地一个名为docs.txt的文件,这个文件就是作为外部知识库,里面会写一些文本内容。
- 在这个实际的操作中,我们会使用RAG读取本地一个名为docs.txt的文件,这个文件就是作为外部知识库,你们会写一些文本内容。
之前的文章中多次提到了各种提示词范式,比如零样本、少样本、CoT等等。 合理使用这些技术,可以某种程度上提高外面对AI的使用效率,但这时候的AI给出的结论还是基于它自己的训练数据,那么有没有一种方式,可以让AI可以在我们自己的文档、知识库等外部数据的基础上进行思考、推理和检索,得到最终更加接近事实的结果的方法呢?
答案就是RAG。
RAG(Retrieval-Augmented Generation,检索增强生成) 是目前 Agent(智能体)开发中最核心、最常用的技术之一,几乎所有生产级 Agent 都会用到它。所以,学习agent开发,RAG是一个几乎不可绕过的节点。
基本概念
Meta AI 的研究人员引入了一种叫做检索增强生成(Retrieval Augmented Generation,RAG)的方法来完成这类知识密集型的任务。RAG 把一个信息检索组件和文本生成模型结合在一起。RAG 可以微调,其内部知识的修改方式很高效,不需要对整个模型进行重新训练。
简单来讲,RAG就是让大模型在回答用户问题之前,先去查个资料,再基于查到的资料来生成最终的答案。
这样解决了纯LLM 容易幻觉、 知识截止日期 等问题。
幻觉很好理解,就是模型给你的答复看似一本正经,其实很有可能是一本正经的胡说八道,自己造万物,这就是幻觉。
知识截止日期可能普通人听的不是很多,其实就是一个训练数据的实效性。每一个LLM模型在进行训练之后,它的所有答复都是基于这些训练数据进行的,训练完成之后,模型就不再知道在训练之后新发生的事情了。
换句话说就是,它不像人类一样可以,我们不知道的东西可以去查资料、去请教别人,而RAG的目的,就在于此。
基本流程
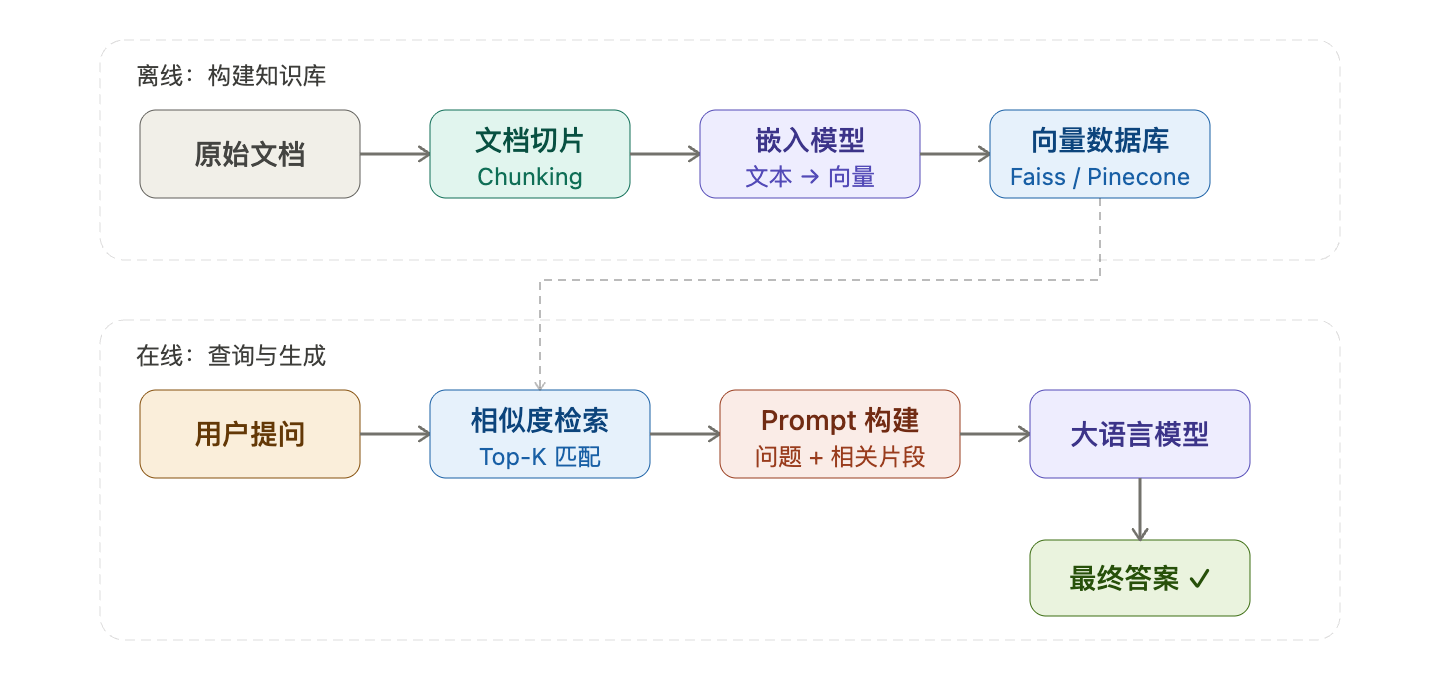
知识库构建: 文档先被切成若干个小片段(chunk),每个片段通过嵌入模型转成向量 ,存入向量数据库。这个过程只需要做一次,之后更新知识只需要重新跑一遍即可。
查询生成: 用户的问题同样被向量化,在库中做相似的搜索,捞出最相关的
Top-k个片段,拼进prompt中,再交给大模型生成最终的回答。
企业内部知识库问答(HR、产品手册)、法律医疗文档检索、客服机器人、基于最新资讯的问答系统——凡是"知识量大、更新频繁、答案需要有据可查"的场景,RAG 都是首选方案。
分类
RAG的分类维度很多,这里主要了解一下按照架构范式进行分类的情况。
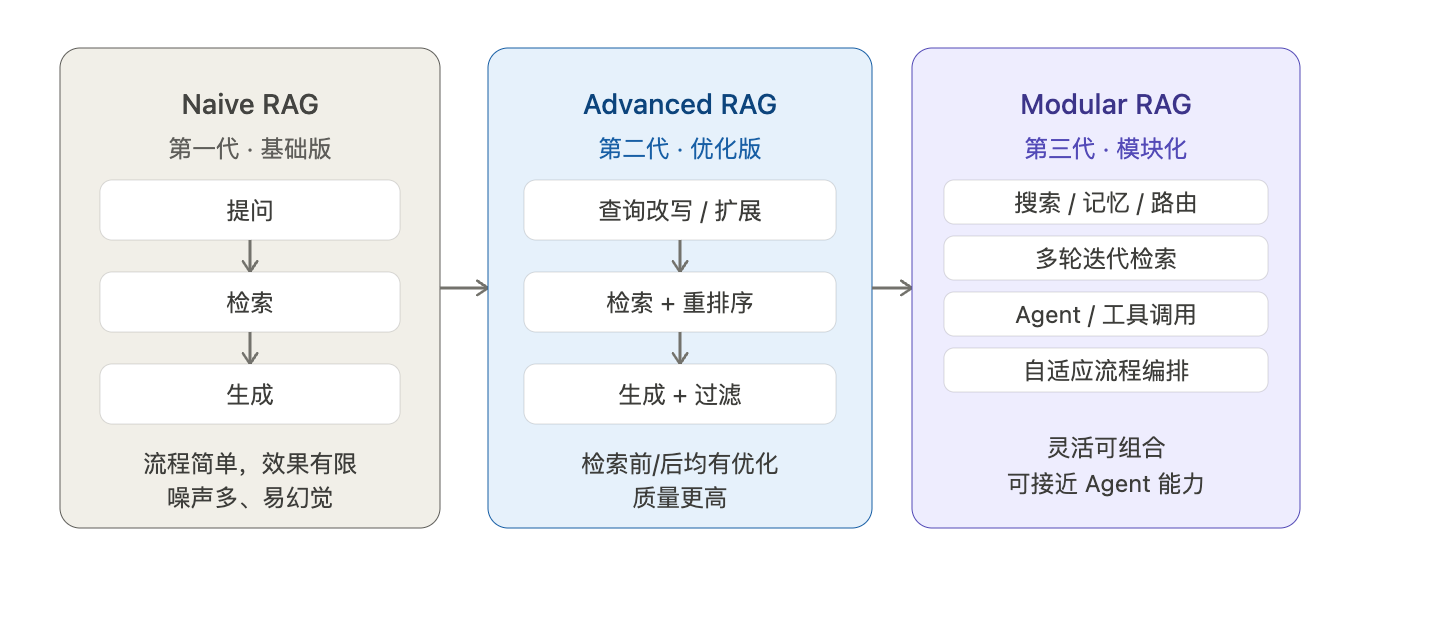
第一代 Naive RAG 就是最基础的"提问→检索→生成",实现简单但问题多:检索回来的内容可能噪声大、和问题不够相关,导致生成质量差。
第二代 Advanced RAG 在前后两端都做了优化:检索前对查询做改写(把模糊问题变精准),检索后对结果做重排序(把最相关的片段排到最前面),质量明显提升。
第三代 Modular RAG 把各个环节拆成独立模块,可以自由组合,甚至引入 Agent 能力,让模型自己决定要不要检索、检索几次、用什么工具——灵活性最高,也最接近真正的智能体。
基本实操
现在进实操。我们先不用 LangChain,继续用纯 Python 在之前学习# ReAct框架解析:从原理到实战的AI推理行动范式的时候创建的那个项目 Agent 里加一个 RAG 工具。
在这个实际的操作中,我们会使用RAG读取本地一个名为
docs.txt的文件,这个文件就是作为外部知识库,里面会写一些文本内容。
慕予科技是一家专注于人工智能和软件开发的科技公司,联合创始人是徐老板和邹老板。

慕予科技的主要产品是 welight,售价为99美元,支持Windows和Mac平台。

welight 是慕予科技旗下的核心产品,主要面向企业用户,提供智能化解决方案。
1. 安装并倒入相关的模块
# 安装RAG组合工具
pip3 install chromadb sentence-transformers
简单介绍一下:
chromadb是一个轻量,本地化的向量数据库,类似于
Pinecone的开源版本。专门用来存储 高维向量(Embedding) 和对应的原始文本。
支持相似度搜索(余弦相似度、欧氏距离等)
优点:安装简单、零配置、速度快、适合本地开发和中小型项目
缺点:大规模生产环境建议换成 Milvus / Weaviate / PGVector
sentence-transformers则是由 Hugging Face 维护的经典库,里面包含了大量预训练的Embedding模型,(如 all-MiniLM-L6-v2、bge-small-zh-v1.5 等)
能把一句话或者一段文本转成 固定维度的向量 比如384维
# 导入模块
import chromadb
from sentence_transformers import SentenceTransformer
2. 初始化RAG
# ─────────────────────────────────────────
# RAG 初始化
# ─────────────────────────────────────────
embedding_model = SentenceTransformer("all-MiniLM-L6-v2")
chroma_client = chromadb.Client()
collection = chroma_client.create_collection("my_docs")

# 读取本地 docs.txt
with open("docs.txt", "r", encoding="utf-8") as f:
    content = f.read()

# 按段落切割(空行分隔),过滤掉空段落
documents = [p.strip() for p in content.split("\n\n") if p.strip()]

# 向量化存入 ChromaDB
embeddings = embedding_model.encode(documents).tolist()
collection.add(
    documents=documents,
    embeddings=embeddings,
    ids=[f"doc{i}" for i in range(len(documents))]
)

print(f"已加载 {len(documents)} 个文档块")
建议行在模型客户端初始化的下方。
3. 工具函数 + 注册 + Schema
def query_local_docs(question: str) -> str:
    """在本地文档库中检索与问题最相关的内容"""
    query_embedding = embedding_model.encode([question]).tolist()
    results = collection.query(
        query_embeddings=query_embedding,
        n_results=2  # 返回最相关的 2 条
    )
    docs = results["documents"][0]
    return "\n".join(docs) if docs else "本地文档中未找到相关内容"


# 加进 TOOLS
TOOLS = {
    "search": search,
    "calculator": calculator,
    "get_current_time": get_current_time,
    "get_exchange_rate": get_exchange_rate,
    "query_local_docs": query_local_docs,  # 新增
}

# 加进 TOOL_SCHEMAS
{
    "type": "function",
    "function": {
        "name": "query_local_docs",
        "description": "在本地私有文档中查询信息,适合查询内部资料、产品文档、私有知识库等",
        "parameters": {
            "type": "object",
            "properties": {
                "question": {
                    "type": "string",
                    "description": "要查询的问题或关键词"
                }
            },
            "required": ["question"]
        }
    }
}
测试
run_agent("慕予科技是做什么的?")由于我们的项目之前加入了真实的联网搜索功能,所以为了更好的体验RAG过程,建议在主循环代码中的message不会加上几句prompt:
 messages = [
        {
            "role": "system",
            "content": (
                # f"你是一个智能助手。今天的日期是 {date.today()}。"
                "回答问题时,优先使用 query_local_docs 查询本地文档。"  # 加这行
                "如果本地文档已有足够信息,直接根据本地文档回答,不需要再联网搜索。"  # 加这行
                "只有本地文档没有相关信息时,才使用 search 联网搜索。"  # 加这行
                "回答前先判断是否需要工具获取信息。"
                "需要时调用工具,拿到结果后再综合给出最终答案。"
                "如果问题可以直接回答则无需调用工具。"
                "请用中文回答。"
            ),
        },
        {"role": "user", "content": user_question},
    ]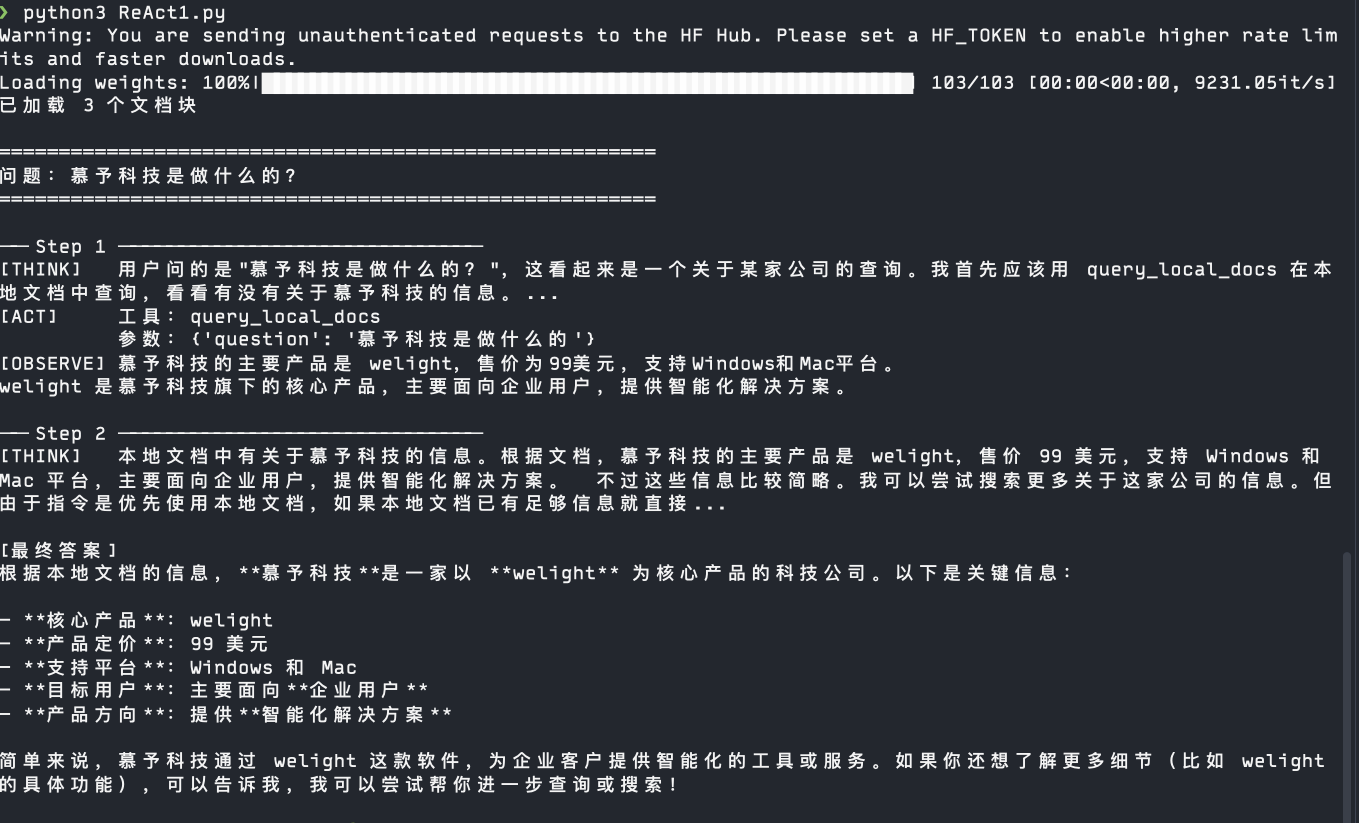
首次运行会下载向量模型(约 90MB),需要等一会儿。
版权声明
本文内容版权归作者或相关权利人所有。转载、引用或其他使用请遵循相应授权条款,并保留本文链接。