Agent开发 · 文章
深入理解LangChain与LangGraph:以PenFlow项目为例的实战解析
本文以 PenFlow(微信公众号内容助手)项目为主线,结合真实代码,系统讲解 LangChain 和 LangGraph 的核心概念。
1. 整体架构一览
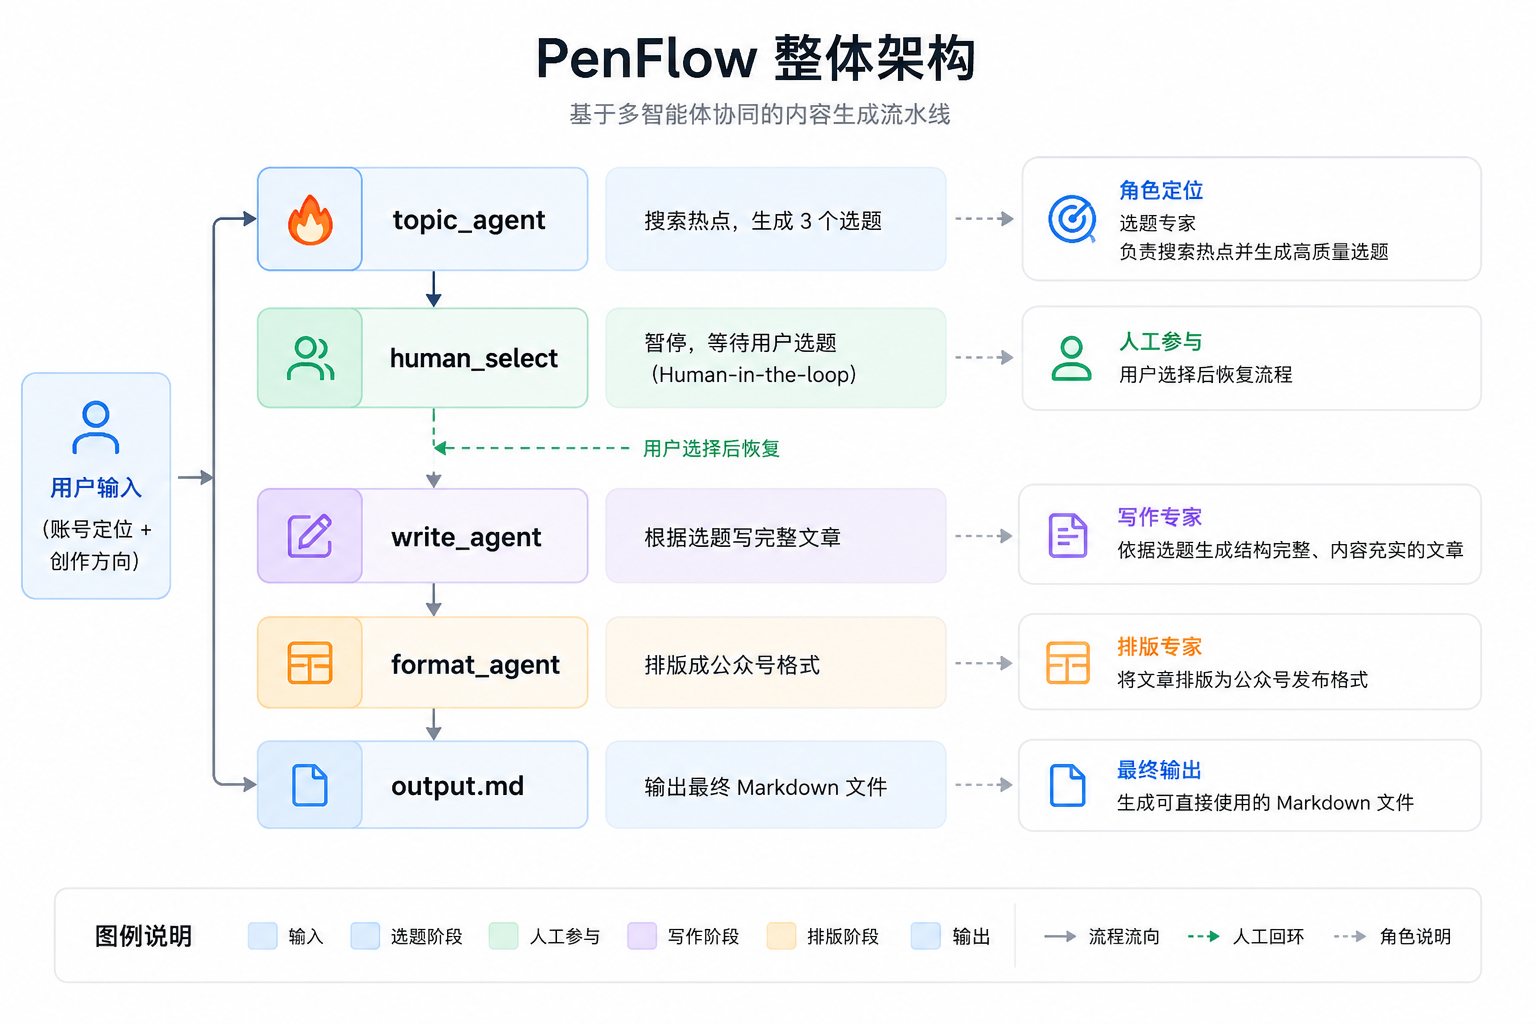
PenFlow 是一个多 Agent 协作的内容创作系统,当前版本并非一个生产级别的项目,主要是用来作为Agent开发学习的一个Demo级别的Agent。整体架构如下:
技术栈分层:
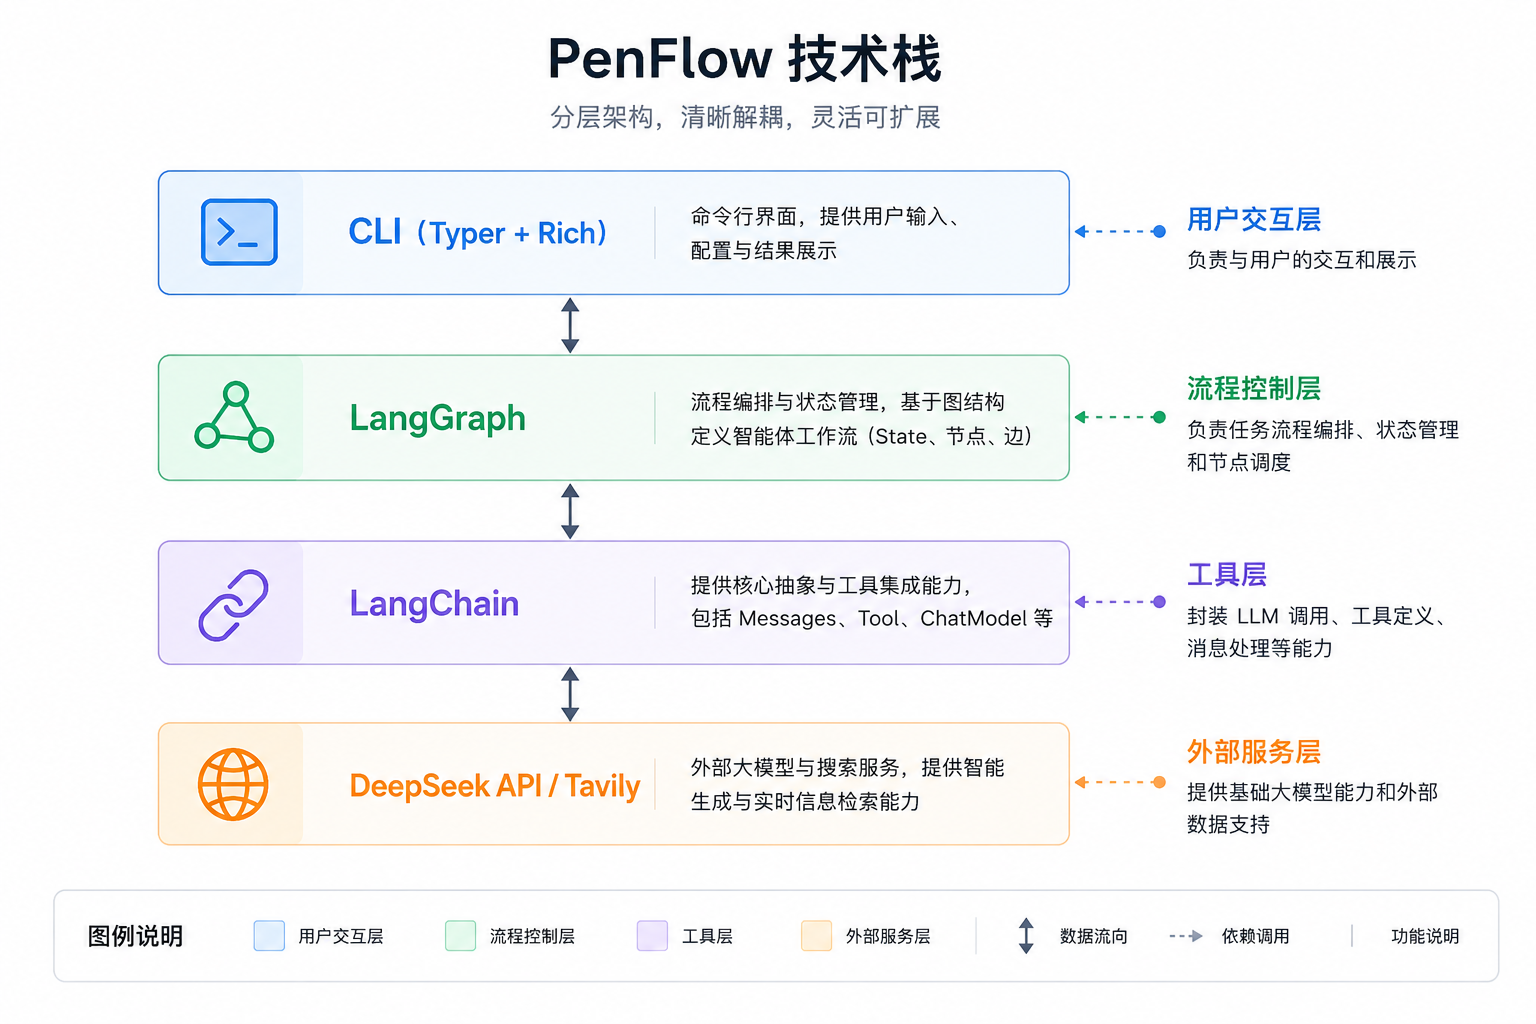
一句话区分 LangChain 和 LangGraph:
LangChain = 工具箱(提供 Messages、Tool、ChatModel 等零件)
LangGraph = 流水线控制器(决定零件按什么顺序、什么条件组装运行)
2. LangChain 核心概念
2.1 Messages 消息体系
LangChain 把所有对话内容统一抽象成 Message 对象,不同角色用不同类型:
from langchain_core.messages import SystemMessage, HumanMessage, AIMessage, ToolMessage类型 | 角色 | 用途 |
|---|---|---|
| system | 设定 AI 的身份和行为规则 |
| user | 用户的输入 |
| assistant | 模型的回复(可能包含 tool_calls) |
| tool | 工具执行结果,传回给模型 |
在 PenFlow 中的使用(topic.py):
messages = [
    SystemMessage(content=system_prompt),      # 告诉模型:你是选题策划师
    HumanMessage(content="请推荐3个选题...")   # 用户的请求
]
response = llm_with_tools.invoke(messages)
# response 是 AIMessage,可能包含 tool_calls(调用搜索工具)
消息流的完整生命周期:
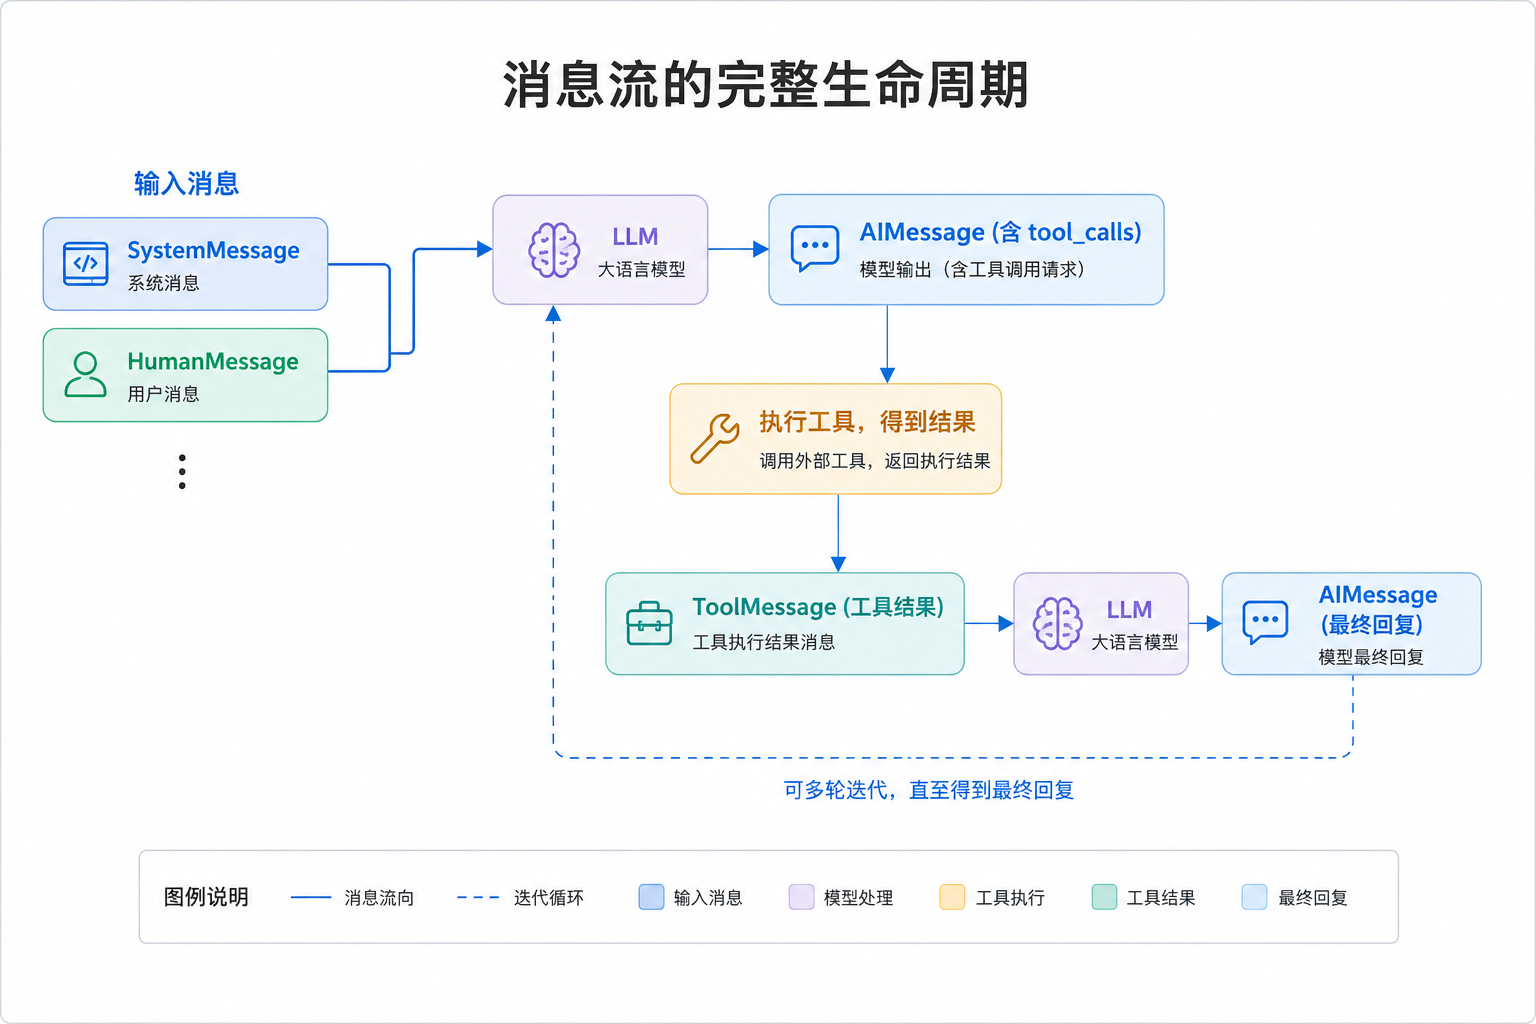
为什么用 Message 对象而不是普通字符串?
因为 LLM 的 API 需要区分不同角色的内容。把所有内容统一成 Message 对象后, 框架可以自动序列化成 API 需要的格式,你不需要手动拼 JSON。
2.2 ChatModel 与 bind_tools
ChatModel 是 LangChain 对所有 LLM 的统一抽象。PenFlow 用 ChatOpenAI 连接 DeepSeek:
from langchain_openai import ChatOpenAI

llm = ChatOpenAI(
    model="deepseek-v4-pro",
    api_key=deepseek_key,
    base_url="https://api.deepseek.com",   # 替换 base_url 即可接入任何 OpenAI 兼容模型
    temperature=0.7,
    extra_body={"thinking": {"type": "disabled"}},  # DeepSeek 特有参数
)
bind_tools:把工具能力绑定到模型
llm_with_tools = llm.bind_tools([search_tool])bind_tools 做了什么?它把工具的描述(名称、参数格式)注入到每次 API 调用里, 让模型知道"我可以调用这些工具"。
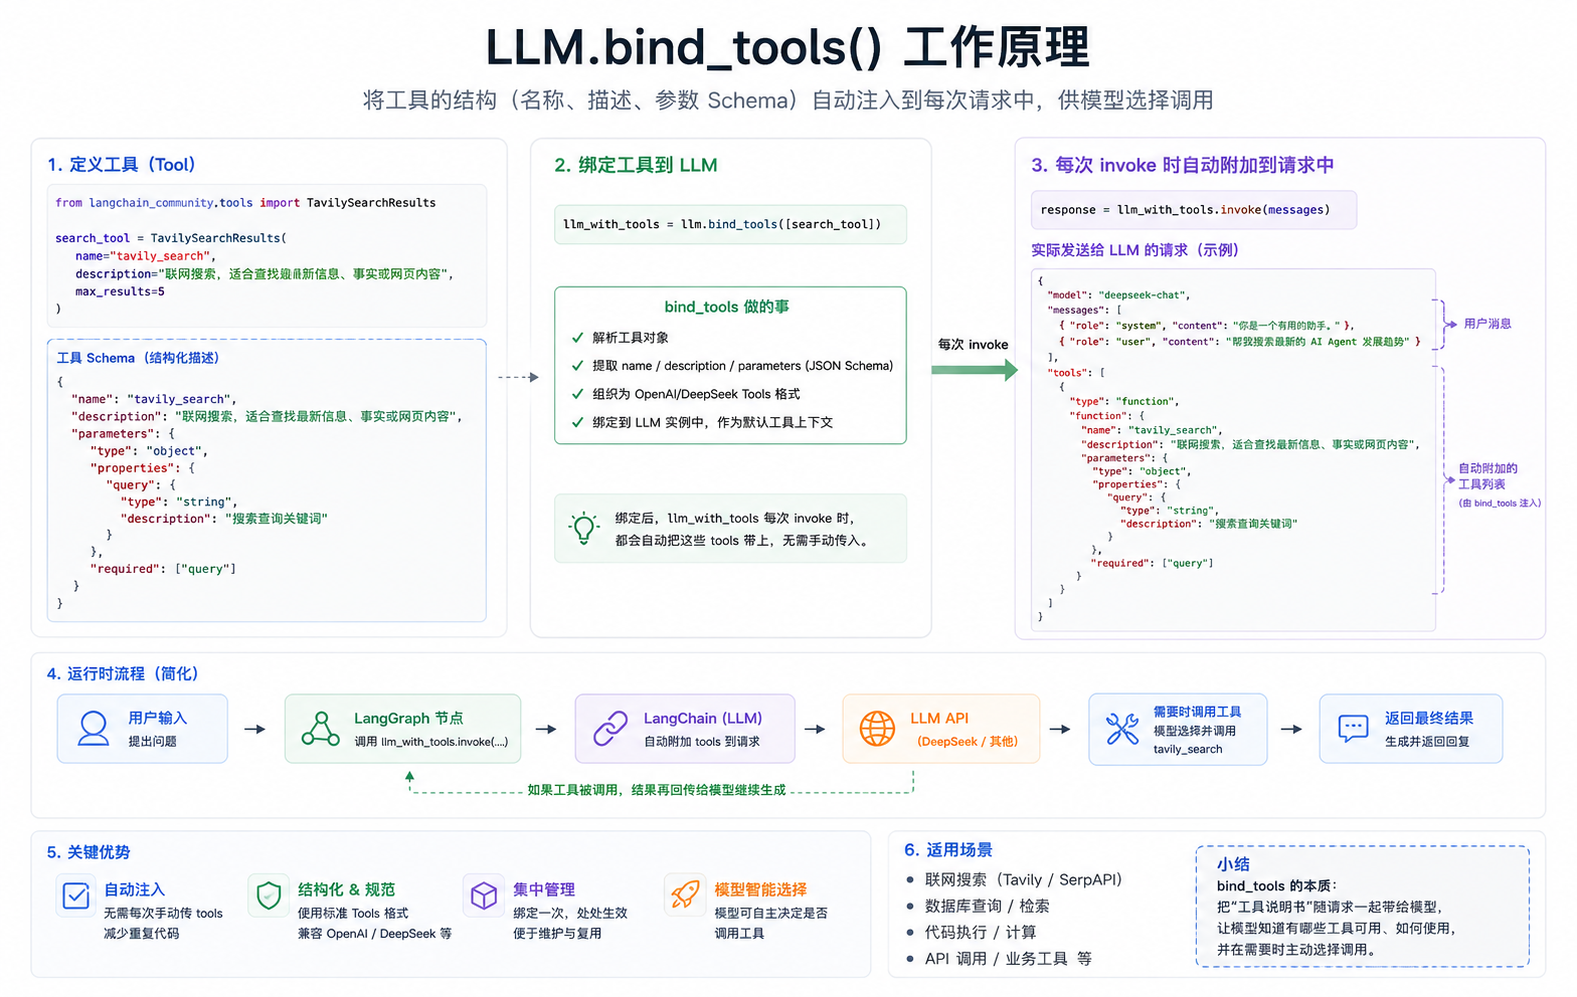
两个 LLM 实例的区别:
llm              # 普通模型,用于写作和排版(不需要工具)
llm_with_tools   # 绑定了搜索工具的模型,用于选题(需要联网)
关键设计原则: 不同 Agent 绑定不同工具,让每个 Agent 只能调用它职责范围内的工具, 避免模型"乱用"工具。
2.3 Tool 工具
LangChain 的 @tool 装饰器是定义工具最简洁的方式:
from langchain_core.tools import tool

# 方式一:@tool 装饰器(PenFlow 使用的方式)
# 函数的 docstring 自动成为工具描述
# 参数的类型注解自动成为参数 Schema
@tool
def calculator(expression: str) -> str:
    """执行数学计算,输入合法的 Python 数学表达式,如 '3 * (12 + 5)'"""
    try:
        return f"计算结果:{eval(expression)}"
    except Exception as e:
        return f"计算出错:{e}"
@tool 的魔法:自动生成 Schema
# 你写的:
@tool
def calculator(expression: str) -> str:
    """执行数学计算"""
    ...

# 框架自动生成的 Schema(传给 LLM):
{
  "name": "calculator",
  "description": "执行数学计算",
  "parameters": {
    "type": "object",
    "properties": {
      "expression": {
        "type": "string"
      }
    },
    "required": ["expression"]
  }
}
vs 手写版 Schema
# 手写版(繁琐,容易出错)
TOOL_SCHEMAS = [{
    "type": "function",
    "function": {
        "name": "calculator",
        "description": "执行数学计算,输入合法的 Python 数学表达式,如 '3 * (12 + 5)'",
        "parameters": {
            "type": "object",
            "properties": {
                "expression": {"type": "string", "description": "数学表达式"}
            },
            "required": ["expression"]
        }
    }
}]
@tool 把这些全部自动化了。
2.4 工具循环(Tool Loop)
这是理解 Agent 的最核心机制。模型不是"一次性"调用工具,而是可以多轮调用,直到它认为信息足够为止。
PenFlow 的 run_tool_loop 函数实现了这个循环:
def run_tool_loop(llm_with_tools, tools_by_name, messages, max_steps=6):
    local_messages = list(messages)

    for _ in range(max_steps):
        # 1. 调用模型,让它决定下一步
        response = llm_with_tools.invoke(local_messages)

        # 2. 如果模型不调用工具,说明信息足够,返回最终回复
        if not (hasattr(response, "tool_calls") and response.tool_calls):
            return response

        # 3. 有 tool_calls,执行工具
        local_messages.append(response)  # 把模型决策加入历史
        for tool_call in response.tool_calls:
            result = tools_by_name[tool_call["name"]].invoke(tool_call["args"])
            # 4. 把工具结果追加到历史
            local_messages.append(ToolMessage(
                content=str(result),
                tool_call_id=tool_call["id"],
            ))
        # 5. 继续循环,让模型看到工具结果后决定下一步

    return response
执行流程图(以选题 Agent 为例):
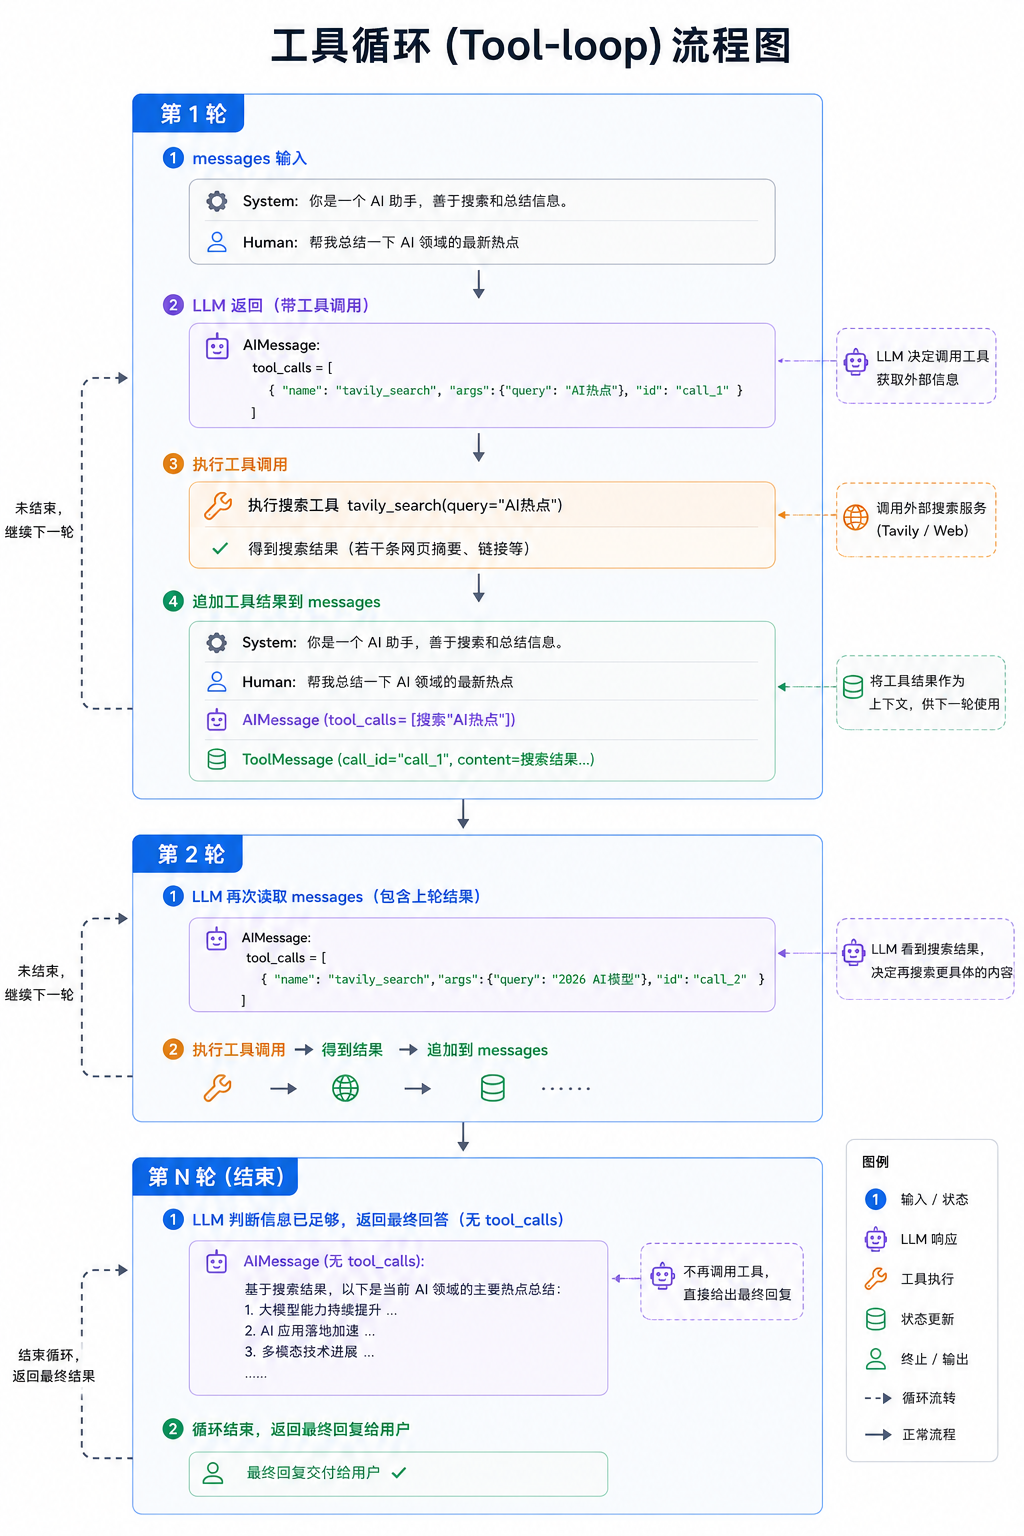
为什么需要 tool_call_id?
当模型同时调用多个工具时,需要知道每个 ToolMessage 对应哪个 tool_call。
tool_call_id就是这个配对标识。如果 AIMessage 里有 tool_calls 但后面没有 对应的 ToolMessage,DeepSeek 会报 400 错误——这是我在 PenFlow 开发中踩过的一个坑。
3. LangGraph 核心概念
3.1 State:图的血液
State 是贯穿整个图的共享数据结构,所有节点都从它读数据、往它写数据。
PenFlow 的 State 定义(graph.py):
from typing import Annotated
from typing_extensions import TypedDict
from langgraph.graph.message import add_messages

class State(TypedDict):
    messages: Annotated[list, add_messages]  # 对话历史
    account_position: str                     # 账号定位(用户输入)
    content_direction: str                    # 创作方向(用户输入)
    topics: list                              # 选题Agent生成的3个选题
    selected_topic: str                       # 用户选定的选题
    article: str                              # 写作Agent生成的文章
    formatted_article: str                    # 排版后的最终文章
    next: str                                 # 路由目标
为什么用 TypedDict 而不是普通 dict?
# 普通 dict —— 有三个问题:
state = {}
state["topics"] = ["选题1"]
state["topics"] = ["选题2"]  # 直接覆盖,上一条消失了

# TypedDict + Reducer —— 解决了这些问题:
# 1. 类型检查:框架知道每个字段的类型,可以在编译时验证
# 2. Reducer:通过 Annotated 声明字段的合并策略
# 3. IDE 支持:有代码补全和类型提示
Annotated 和 Reducer 的秘密:
在 LangGraph 中,State 是一个共享的状态对象(通常是 TypedDict)。
当多个节点(Node)往同一个状态字段写入数据时,默认行为是覆盖(overwrite)。但很多时候我们不希望覆盖,尤其是 messages(对话历史) —— 我们希望追加(append)而不是覆盖。Reducer 就是用来定义“这个字段该怎么合并新旧数据”的函数。
messages: Annotated[list, add_messages]
#         ─────────────  ────────────
#              类型         Reducer函数
add_messages 是一个 reducer 函数,它告诉 LangGraph: "当节点往 messages 写新内容时,追加而不是覆盖"。
# 没有 reducer(普通字段):
state["article"] = "第一版文章"
state["article"] = "第二版文章"  # 覆盖,只保留最新值 ✓(这是我们想要的)

# 有 add_messages reducer:
state["messages"] = [msg1]
state["messages"] = [msg2]  # 追加,变成 [msg1, msg2] ✓(对话历史需要累积)
State 字段的设计原则:
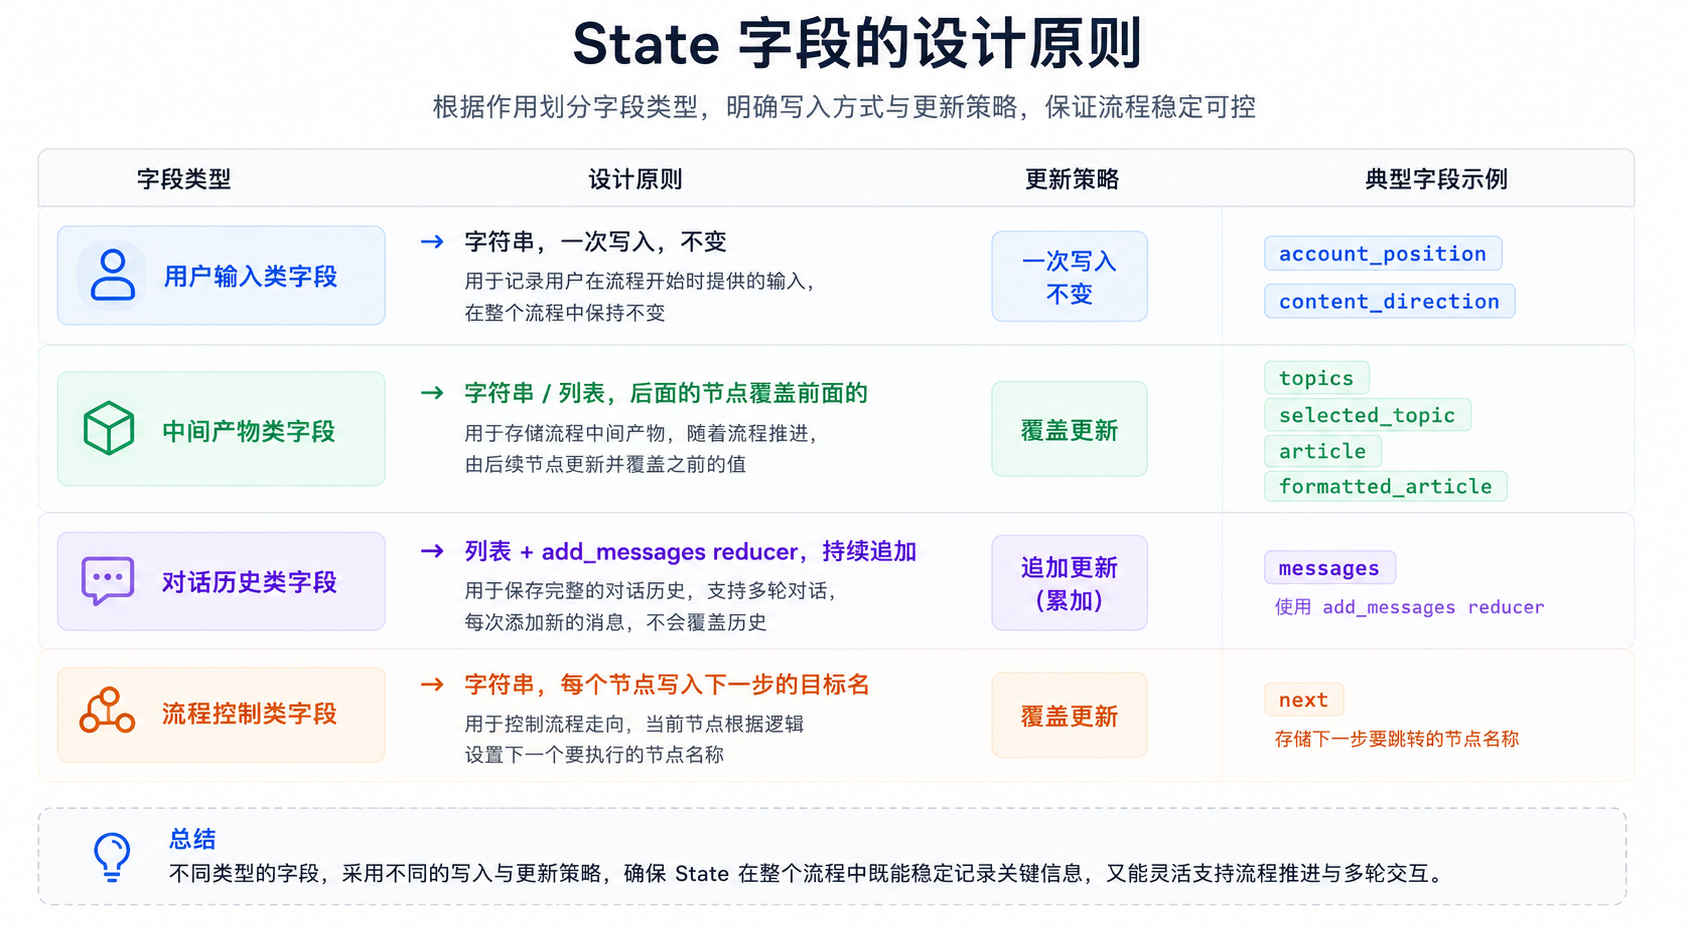
3.2 Node:图的器官
节点是图中的处理单元,本质上就是一个 Python 函数:
# 节点函数的签名:
# 输入:当前 State
# 输出:对 State 的部分更新(不需要返回完整 State)

def writer_node(state: State) -> dict:
    article = write_something(state["selected_topic"])
    return {
        "article": article,    # 只返回需要更新的字段
        "next": "format_agent" # 告诉框架下一步去哪
    }
PenFlow 的四个节点:
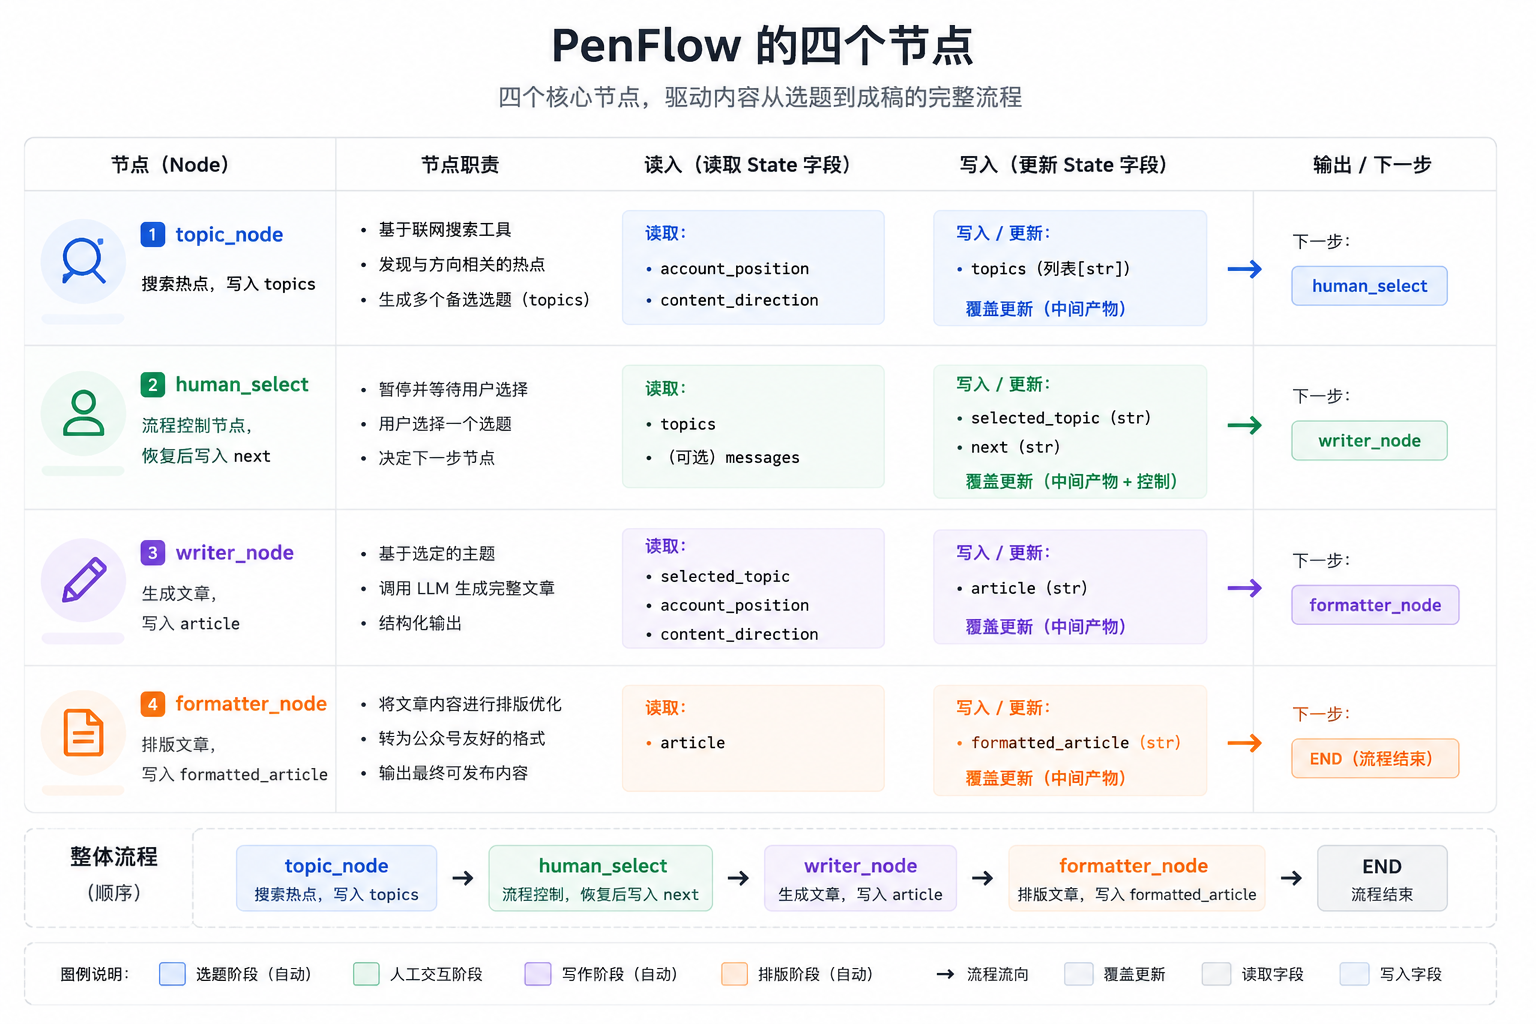
工厂函数模式(PenFlow 的设计选择):
PenFlow 的节点不是直接定义的函数,而是通过工厂函数生成的:
# 工厂函数模式
def build_topic_agent(llm, tavily_key: str):
    # 在这里初始化工具(只初始化一次)
    search_tool = TavilySearch(tavily_api_key=tavily_key)
    llm_with_tools = llm.bind_tools([search_tool])

    # 返回真正的节点函数(闭包捕获上面的变量)
    def topic_node(state: dict) -> dict:
        # 使用外部的 llm_with_tools 和 search_tool
        ...

    return topic_node  # 返回函数,不是调用结果
为什么用工厂函数?
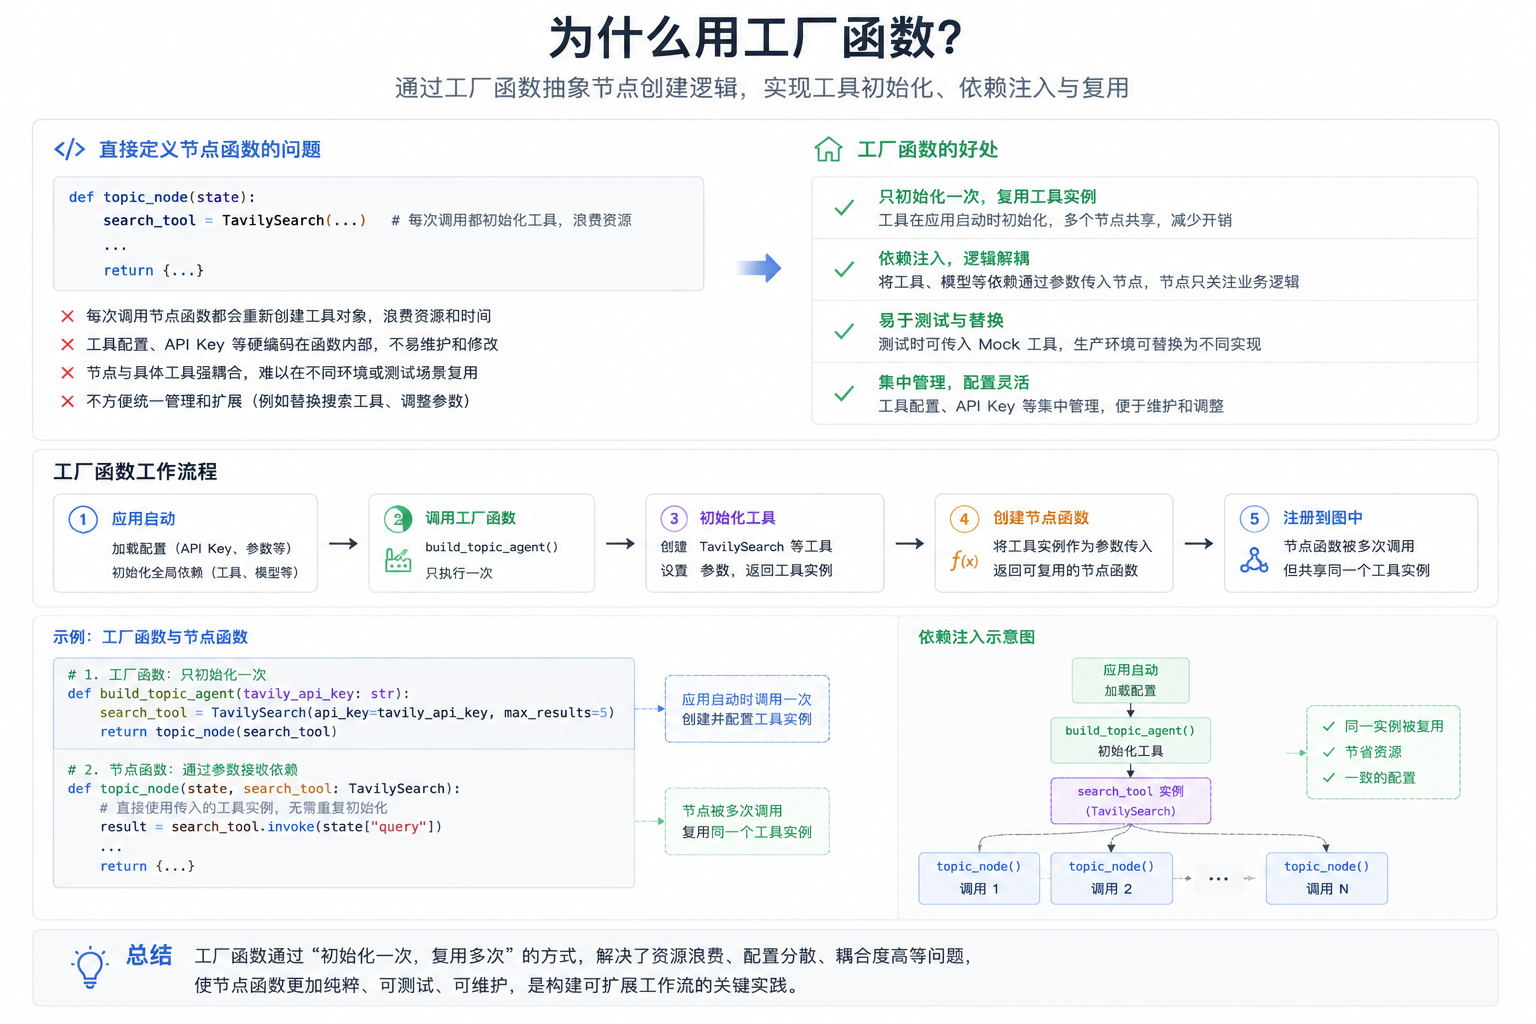
3.3 Edge:图的神经
Edge(边)定义了节点之间的连接关系,决定执行顺序。
两种边:
# 1. 固定边:A 执行完一定去 B
builder.add_edge("A", "B")

# 2. 条件边:A 执行完根据条件决定去哪
builder.add_conditional_edges("A", router_fn, {
    "go_to_B": "B",
    "go_to_C": "C",
})
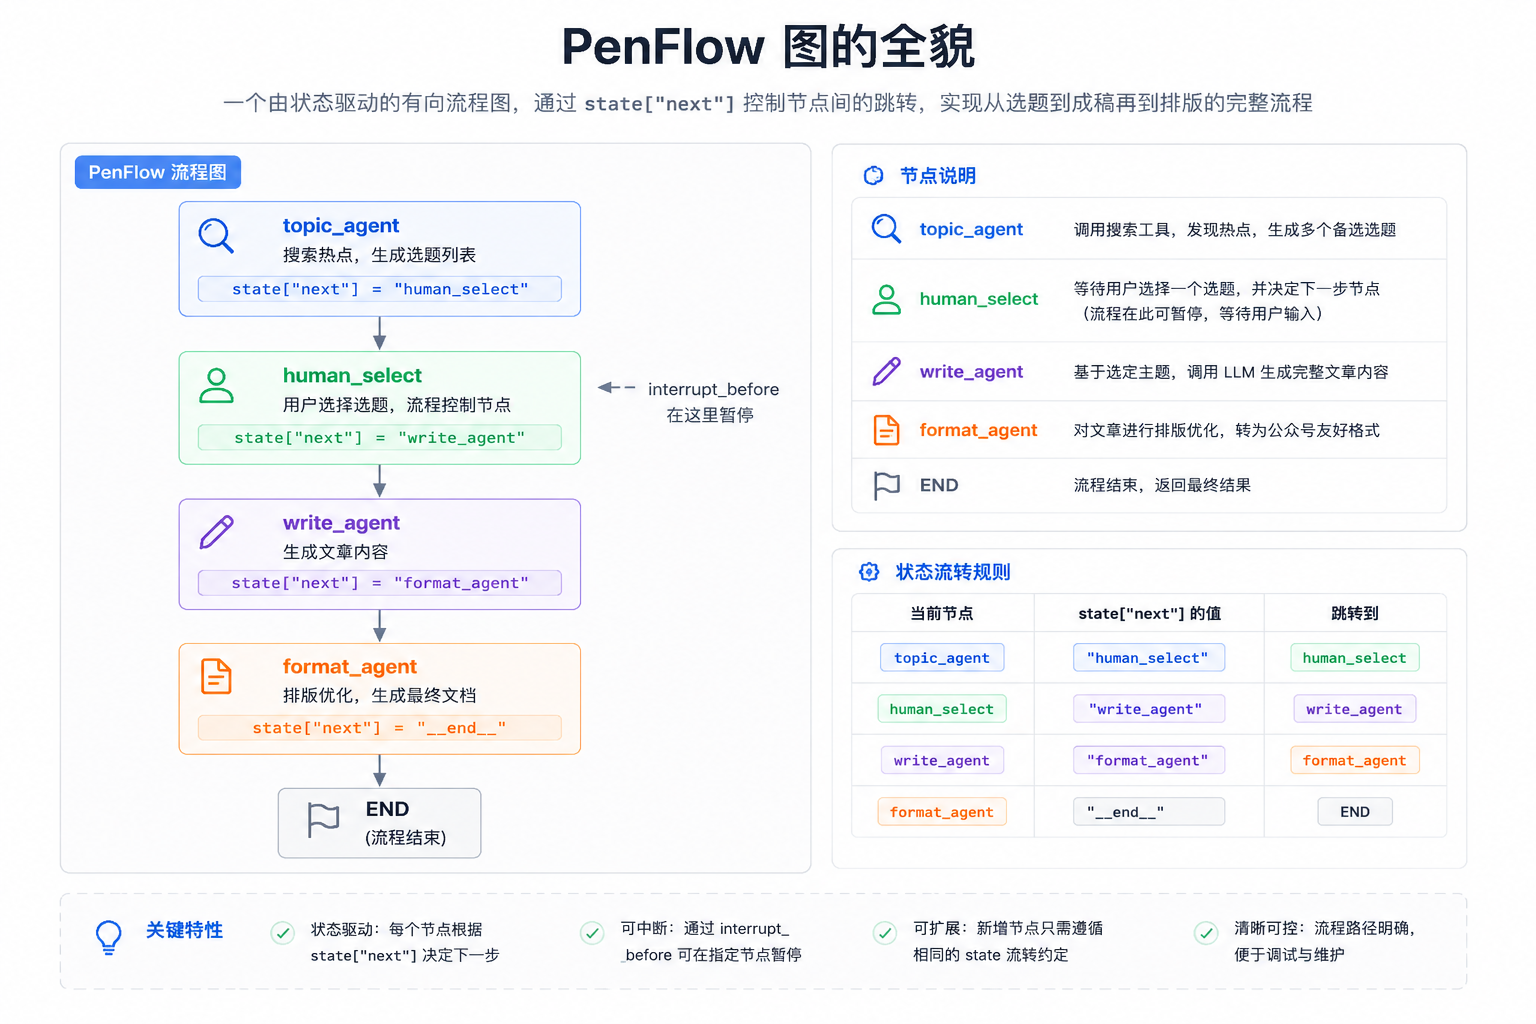
PenFlow 只用了条件边:
builder.add_conditional_edges("topic_agent", router, {
    "human_select": "human_select",
    END: END
})
这里的 router 函数:
def router(state: State):
    return state.get("next", END)
    # 读取 state["next"],返回下一步的节点名字
所以节点只需要往 state["next"] 写目标名字,router 就会把流程引导过去。
图的全貌:
3.4 条件边(Conditional Edge)详解
add_conditional_edges 的三个参数:
builder.add_conditional_edges(
    "topic_agent",        # 参数1:从哪个节点出发
    router,               # 参数2:路由函数,接收 State,返回字符串
    {                     # 参数3:路由函数返回值 → 目标节点 的映射表
        "human_select": "human_select",
        END: END
    }
)
执行逻辑:
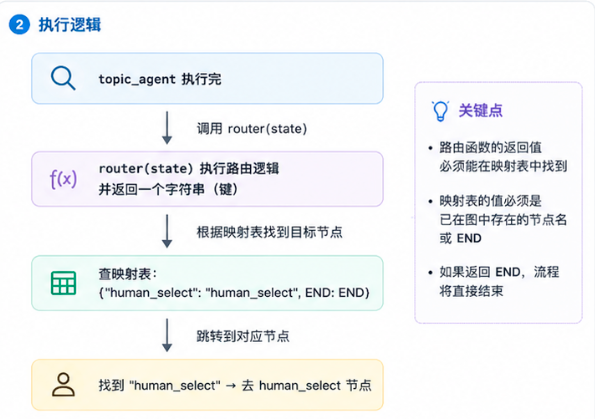
映射表的作用: 路由函数返回的字符串和节点名字不一定要一样, 映射表提供了一层解耦。比如你可以这样:
# 路由函数返回内部状态码
def router(state):
    if state["topics"]:
        return "has_topics"
    return "no_topics"

# 映射表把状态码翻译成节点名
builder.add_conditional_edges("topic_agent", router, {
    "has_topics": "human_select",
    "no_topics": "topic_agent",   # 没有选题就重试
})
3.5 Checkpointer:图的记忆
Checkpointer 是 LangGraph 的持久化机制,它负责在每个节点执行后保存完整的 State 快照。
PenFlow 中的使用:
from langgraph.checkpoint.memory import MemorySaver

memory = MemorySaver()
app = builder.compile(
    checkpointer=memory,
    interrupt_before=["human_select"]
)
thread_id:State 的地址
config = {"configurable": {"thread_id": "session_2026-05-10"}}

# 第一次 invoke:创建快照,存入 memory["session_2026-05-10"]
app.invoke(initial_state, config=config)

# 第二次 invoke:从 memory["session_2026-05-10"] 加载快照,继续执行
app.invoke(None, config=config)
不同的 thread_id = 不同的对话 = 互相隔离的 State。
MemorySaver vs 其他 Checkpointer:
Checkpointer | 存储位置 | 适用场景 |
|---|---|---|
| 内存 | 开发测试,进程结束数据消失 |
| SQLite 文件 | 单机生产,数据持久化 |
| PostgreSQL | 多实例部署,云端生产 |
PenFlow 现在用的是 MemorySaver,适合开发学习阶段。如果上线后应考虑换成 SqliteSaver 或 PostgresSaver。
3.6 Human-in-the-loop:人机协作
这是 PenFlow 最核心的设计,让用户在自动化流程中参与决策。
原理:用 interrupt_before 在指定节点前暂停
app = builder.compile(
    checkpointer=memory,
    interrupt_before=["human_select"]  # 在执行 human_select 之前暂停
)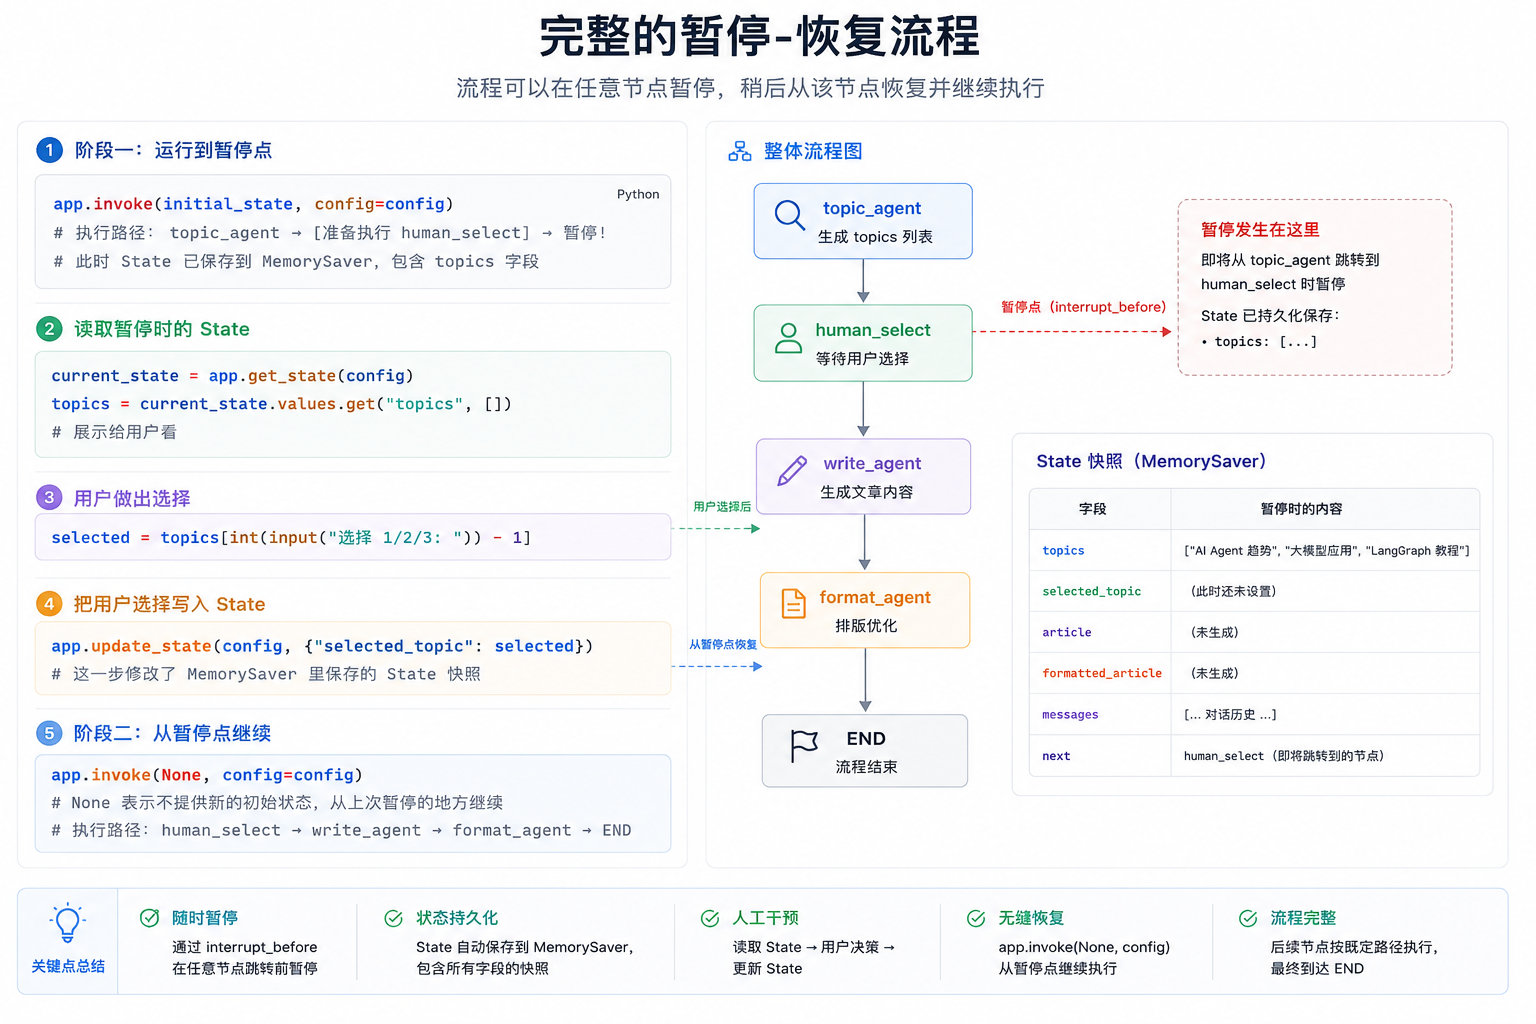
为什么 app.invoke(None, ...) 能继续?
因为 Checkpointer 记住了上次执行到哪里(human_select 节点前), invoke(None) 就是告诉框架:"从记忆里找到这个 thread_id 的断点,继续跑。"
MemorySaver 存储的内容(简化):
{
  "session_2026-05-10": {
    "state": {
      "topics": ["选题1", "选题2", "选题3"],
      "selected_topic": "选题1",  ← update_state 写入的
      ...
    },
    "next_node": "human_select",  ← 从这里继续
    "config": {...}
  }
}
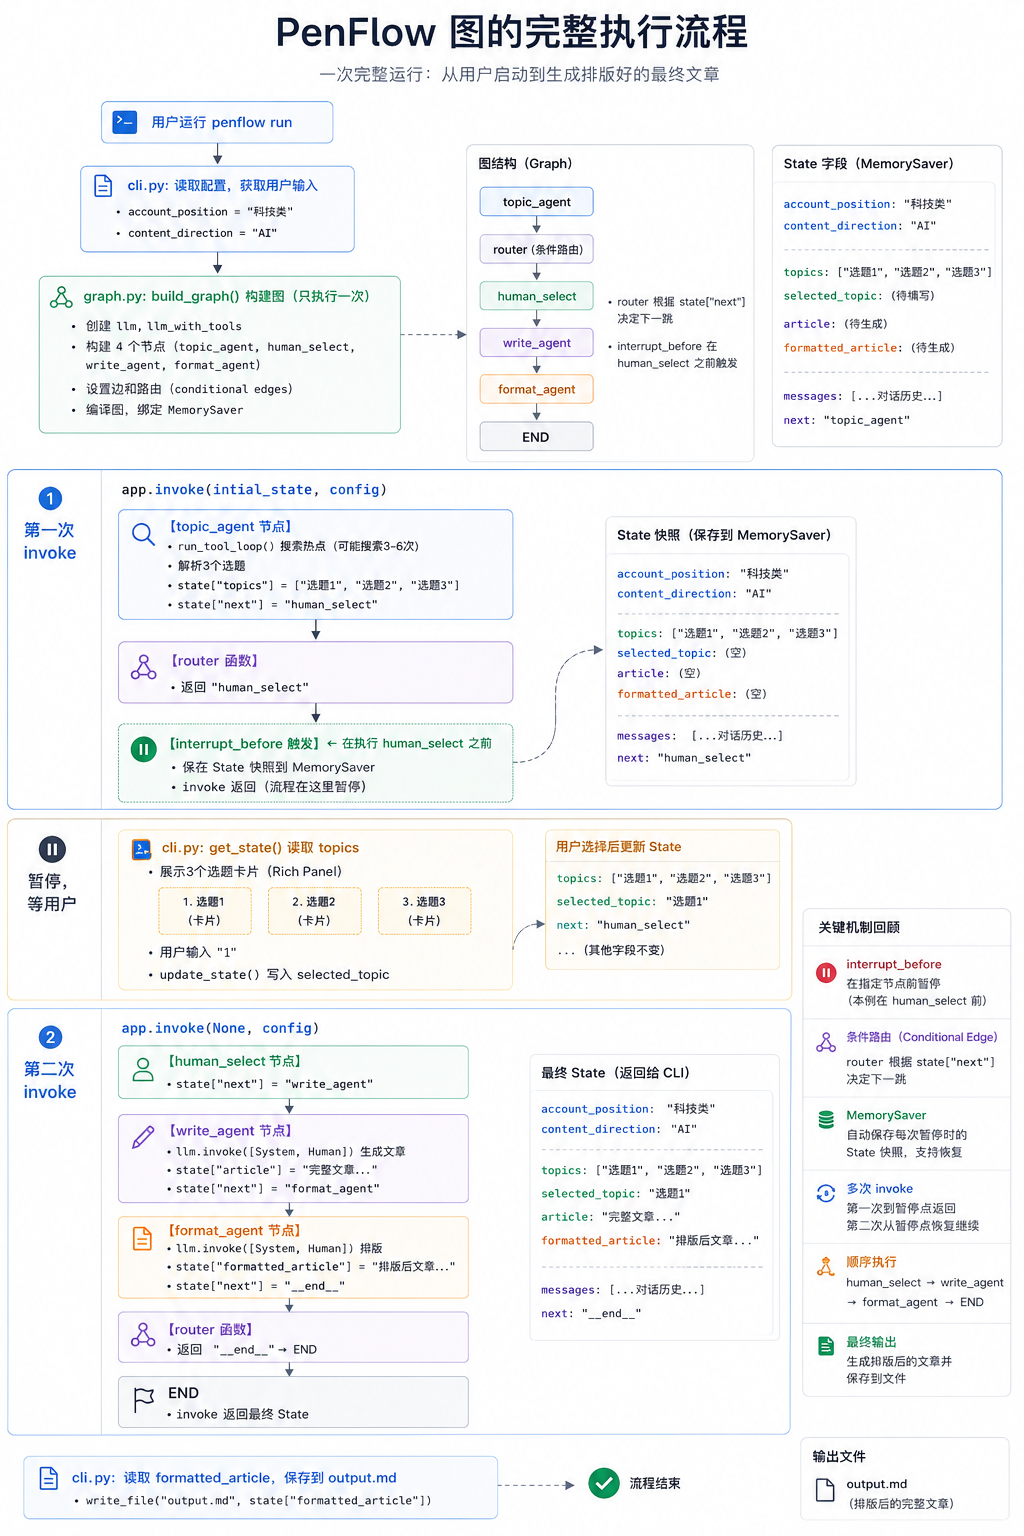
4. PenFlow 图的完整执行流程
把上面所有概念串起来,看一次完整的运行:
5. 设计模式总结
模式一:工厂函数节点
def build_xxx_agent(llm, api_key):
    # 初始化资源(只执行一次)
    tool = SomeTool(api_key=api_key)
    llm_with_tools = llm.bind_tools([tool])

    def xxx_node(state):
        # 使用资源(每次调用执行)
        ...

    return xxx_node  # 返回函数
适用场景:节点需要初始化外部资源(API 客户端、数据库连接等)。
模式二:next 字段路由
# 节点函数里写路由目标
def some_node(state):
    return {"next": "target_node"}

# 统一的路由函数
def router(state):
    return state.get("next", END)

# 所有节点共用一个路由函数
builder.add_conditional_edges("node_a", router, mapping)
builder.add_conditional_edges("node_b", router, mapping)
优点:路由逻辑集中在节点函数里,图的结构清晰,路由函数极简。
模式三:子 Agent 工具循环隔离
def agent_node(state):
    # 内部工具循环,不污染全局 State
    final_response = run_tool_loop(llm, tools, messages)

    # 只把最终结果写入 State
    return {"article": final_response.content}
关键点:工具调用的中间过程(AIMessage with tool_calls + ToolMessages) 不写入全局 State,只把最终文本结果写入。 否则下个节点看到未配对的 tool_calls 会报错。
参考&延伸
版权声明
本文内容版权归作者或相关权利人所有。转载、引用或其他使用请遵循相应授权条款,并保留本文链接。