Agent开发 · 文章
翻译图解 Transformer
版权与来源
原作品著作权归原作者或相关权利人所有。本译文由本站完成,译文相关权利的行使仍受原作品授权条款约束。
原作者:Jay Alammar
宏观视角
先把模型看作一个黑盒。在机器翻译应用中,他接受一种语言的句子,输出另一种语言的翻译。
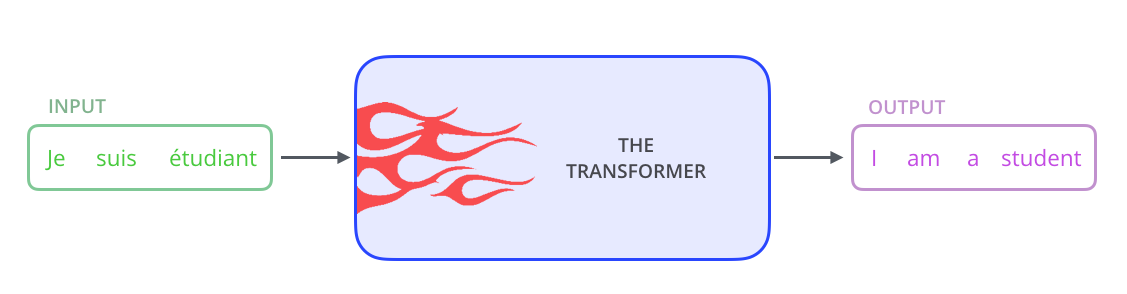
打开这个黑盒,我们可以看到一个 编码组件、一个解码组件 以及他们之间的连接情况。
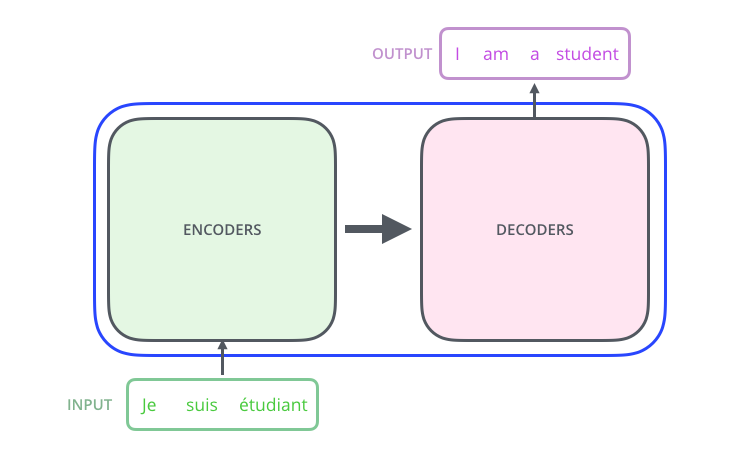
编码组件是由若干个解码器(encoder)堆叠而来(在论文中堆叠了 6 层,但是数字 6 并没有特殊的含义,完全可以尝试其他的配置)。解码组件则是系统数量的解码器(decoder)的堆叠组成。
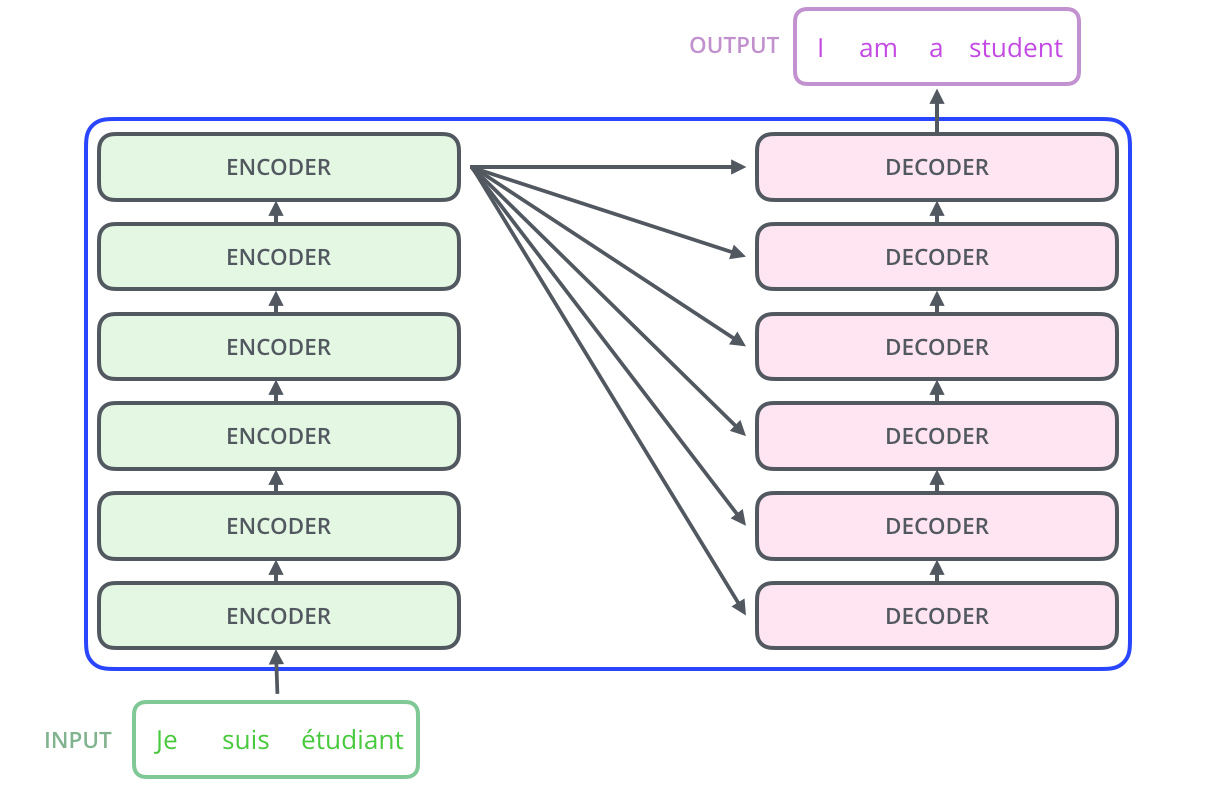
所有解码器的结构系统(但是不共享权重)。每个编码器由两层子层组成:
自注意力层(
Self-Attention):帮助解码器在编码某个词时,能够关注到输入句子中的其他词。前馈神经网络层(
Feed-Forward Network):对每个位置对立、相同的应用。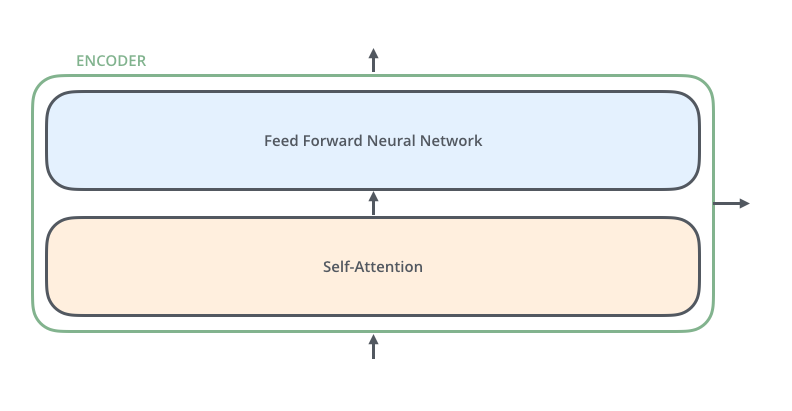
对于 解码器,同样包含这样两个子层,但在他们之间还有一个额外的 编码器-解码器注意力层,帮助解码器生成输出时聚焦于输入句子的相关部分。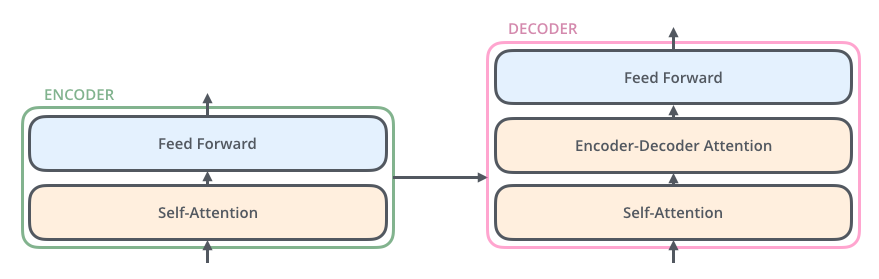
张量的流动
现在我们已经了解了模型的主要组成部分,让我们开始研究各种向量/张量以及他们如何在这些组件之间流动,从而将训练模式的输入转为输出。
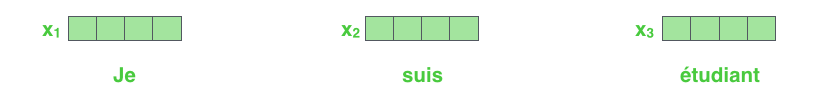
在NLP应用中,我们首先通过 词嵌入(embedding)* 算法将每个输入的词转为向量。每次词被嵌入为 512 维的向量。嵌入操作只在最底层的编码器中进行,其他编码器接收的是下方编码器的输出。
词嵌入完成之后,每个词向量依次流过解码器的两个子层。这里体现了 Transformer的一个关键特性:
每个位置的词都沿着自己独立的路径流动,自注意力层中各路径之间存在依赖关系,而前馈层中没有这种依赖,依次可以 并行执行。
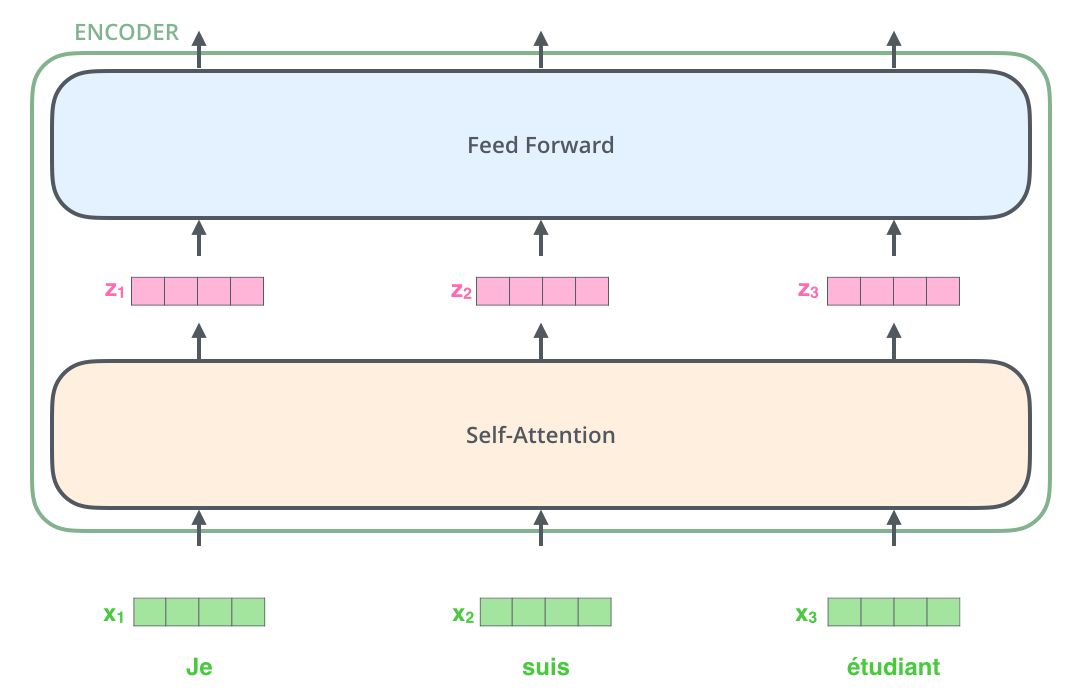
接下来我们将使用一个简短的例子,查看编码器每个子层的运行情况。
正如前面提到的,编码器接收一个向量列表作为输入。他通过将这些向量传递到一个自注意力层,然后传到前馈神经网络,然后将输出向上发送到下一个编码器。
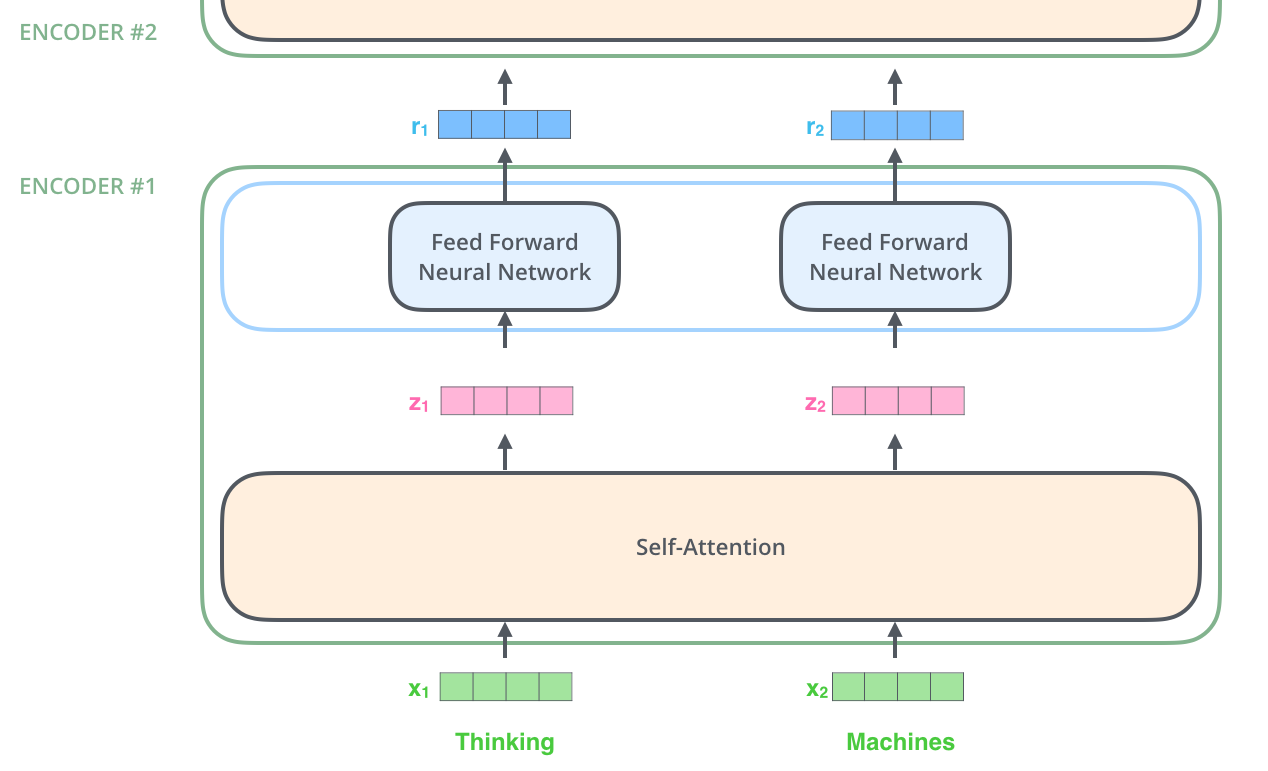
每个位置的单词通过自注意力过程。然后,它们各自通过一个前馈神经网络——完全相同的网络,每个向量单独流过它。
自注意力机制-宏观理解
假设我们要翻译这个句子:
"The animal didn't cross the street because it was too tired." (那只动物没有过马路,因为它太累了。)
这句话中的 it指的是什么?是指的街道还是动物?这对于人类来说很简单,但是对算法来说就不那么简单了。
当模型处理it时,自注意力机制允许将it与动物(animal)关联起来。
当模型处理输入序列中的每个词(每个位置)时,自注意力机制允许它查看输入序列中其他位置,以获取更多可以帮助更好地编码该单词的线索。
如果你熟悉RNN,你可以想象一下,RNN 通过维护隐藏状态,将之前处理过的词/向量的表示融入当前正在处理的词中。自注意力就是Transformer将“对其他相关词的理解”融入当前正在处理词的方法。
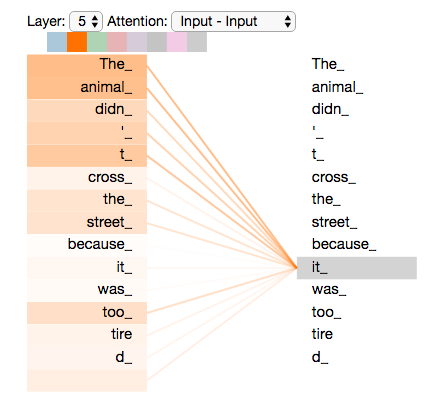
当我们在第 5 层编码器(堆栈中最顶层的编码器)中编码单词 "it" 时,注意力机制的一部分聚焦在了 "The Animal" 上,并将其表示的一部分融入了 "it" 的编码中。
推荐查看 Tensor2Tensor notebook,在那里你可以加载 Transformer 模型,并通过交互式可视化来检验它。
自注意力机制-详细计算
我们先看如何使用向量计算自注意力,再看它实际是如何用矩阵实现的。
计算自注意力的第一步,是从每个编码器的输入向量(即每个词的嵌入)中创建三个向量。
也就是说,对每个词,我们创建一个查询向量(Query)、一个键向量(Key)、一个值向量(Value)。这些向量是通过将词嵌入乘以训练过程中学到的三个权重矩阵得到的。
注意到这些新向量的维度比嵌入向量小。他们的维度是 64,而嵌入和编码器输入/输出向量的维度是 512。他们不是必须更小,这是一个架构上的选择,为了使多头注意力(
multi-headed attention)的计算量大致保持不变。
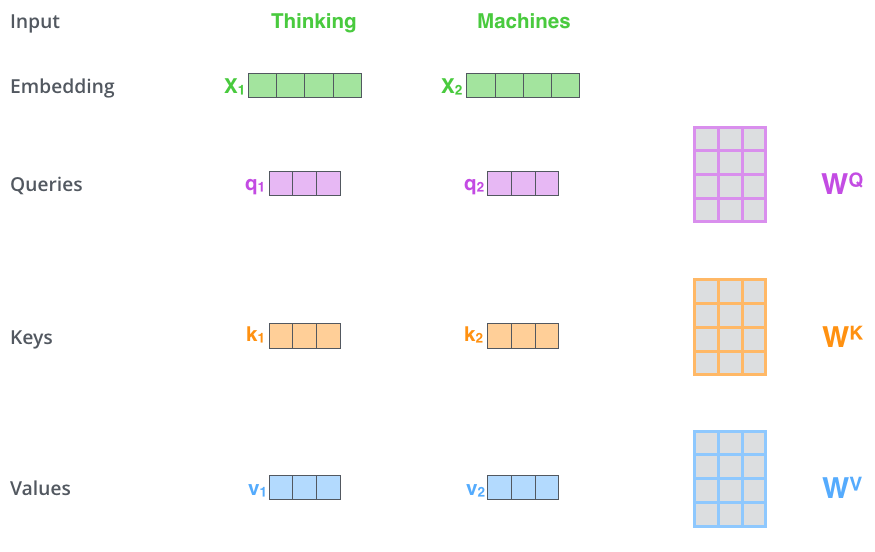
将 x1 与权重矩阵 WQ 相乘,得到 q1,即与该词关联的"查询"向量。最终我们为输入句子中的每个词创建了"查询"、"键"和"值"三种投影。
那么,Query,Key,Value到底是什么?
它们是用于计算和理解注意力机制的抽象概念。等你读完下面关于如何计算注意力的内容,你就会对这三种向量各自扮演的角色有一个充分的了解。
计算自注意力的第二步是计算得分。
假设我们正在计算本例中第一个词Thinking的自注意力,我们需要对输入句子中的每个词,相对于这个词进行打分。这个得分决定了在编码当前位置的词时,应该对输入句子中的其他部分投入多少注意力。
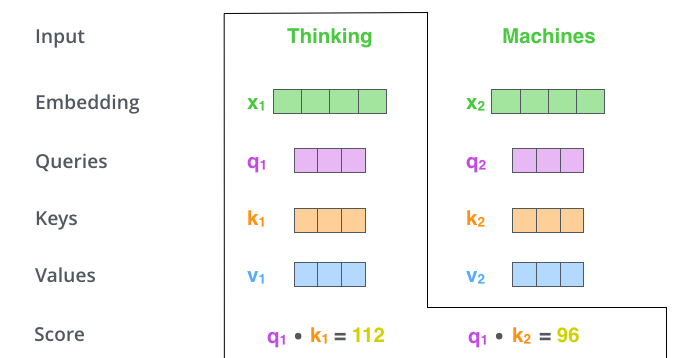
得分的计算方式是:用查询向量与我们正在打分的词的键向量做点积。所以,如果我们在处理位置#1词的自注意力,第一个得分就是q1和k1的点积。第二个得分就是q1和k2的点积 。
第三步和第四步是将得分除以 8(即论文中所有键向量维度 64 的平方根,这有助于梯度更稳定。这里也可以使用其他值,但8 是默认值),然后将结果通过Softmax运行。Softmax将得分归一化,使它们都为正整数且加和为 1。
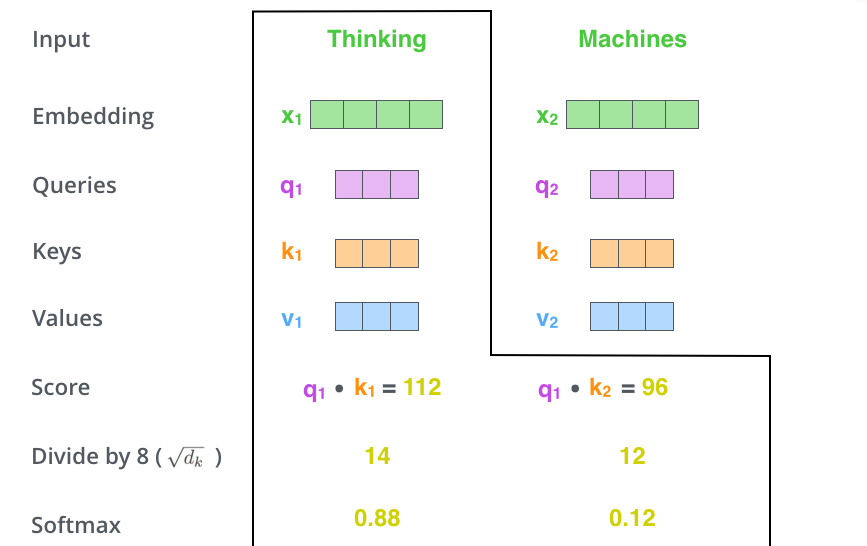
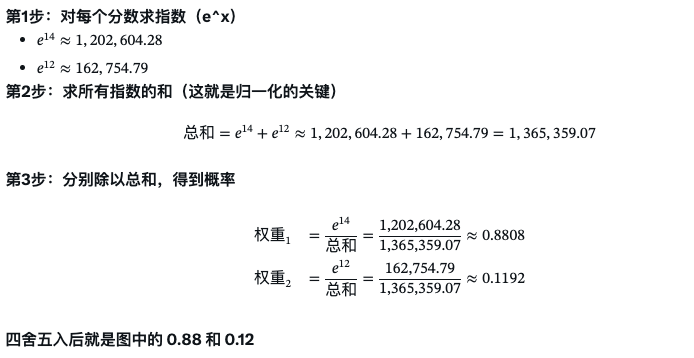
这个softmax得分决定了每个词在当前位置被表达多少。显然,当前位置的词自身会有最高的softmax得分,但有时关注与当前词相关的另一个词也是有用的。
第五步是将每个值向量乘以对应的softmax得分(为后续的求和做准备)。 这里的直觉是:保留我们想关注的词的值,同时淹没不相关的词的影响,例如,将他们乘以0.001这样极小的数。
第六步是将加权后的值向量求和。 这就产生了该位置(针对第一个词)自注意力层的输出。
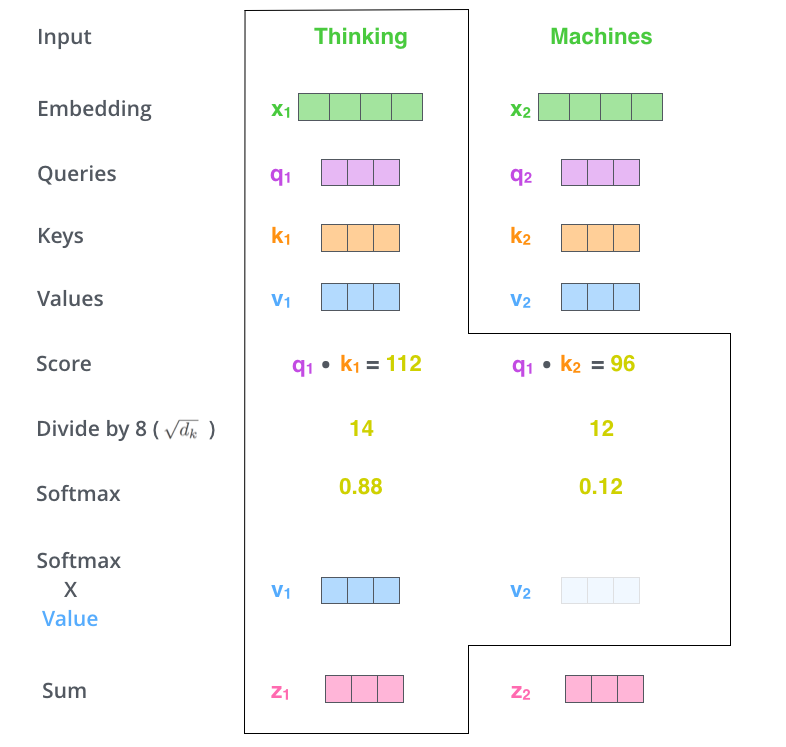
自注意力计算到此结束。得到的向量将被送入前馈神经网络。然而在实际实现中,这一计算是以矩阵的形式进行的,以加快处理速度。所以,在我们了解词级别的计算直觉之后,让我们来看看矩阵形式。
自注意力的矩阵计算
第一步 是计算查询矩阵、键矩阵和值矩阵。我们将所有词嵌入打包成矩阵 X,再乘以我们训练好的权重矩阵(WQ,WK,WV)。
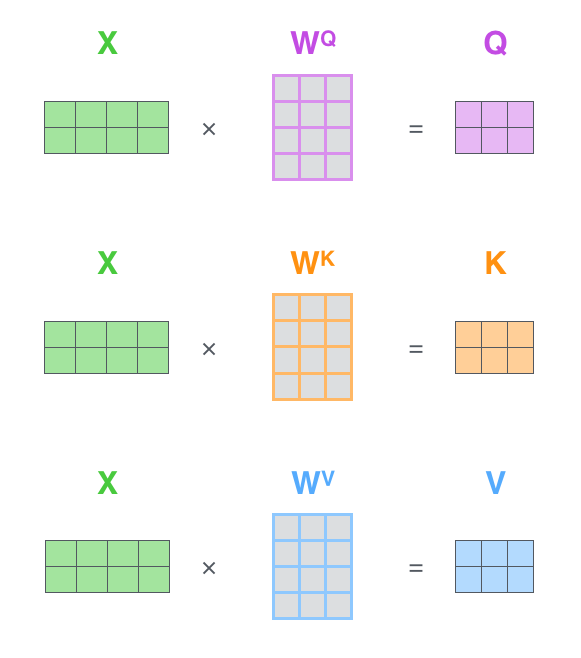
矩阵 X中的每一行对应输入句子中的一个词。我们再次看到嵌入向量(512 维,图中用 4 个方块表示)和 q/k/v 向量(64 维,图中用 3 个方块表示)之间的尺寸差异。
最后,由于我们处理的是矩阵,我们可以将步骤二压缩为一个公式来计算自注意力层的输出。
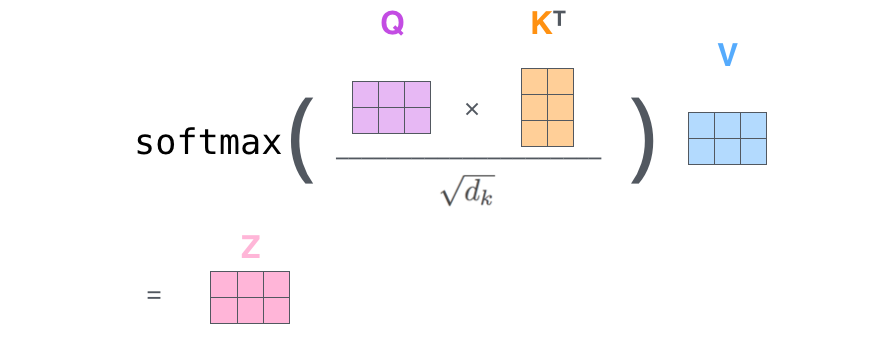
多头怪兽
论文通过添加一种称为“多头”注意力的机制进一步优化了自注意力层。它从两方面提升了注意力层的性能:
扩展了模型关注不同位置的能力。在上面的例子中,z1 包含了一点点其他每个词的编码,但它可能被词自身主导。如果我们在翻译"那只动物没有过马路,因为它太累了"这样的句子时,能知道"it"指的是哪个词,将会很有用。
赋予了注意力层多个“表示子空间” 。接下来我们将看到,在多头注意力机制下,我们不只有一组,而是有多组查询/键/值权重矩阵(Transformer 使用 8 个注意力头,因此每个编码器/解码器最终有 8 组)。每组权重矩阵都是随机初始化的。然后,经过训练,每组矩阵被用于将输入嵌入(或来自下方编码器/解码器的向量)投影到不同的表示子空间中。
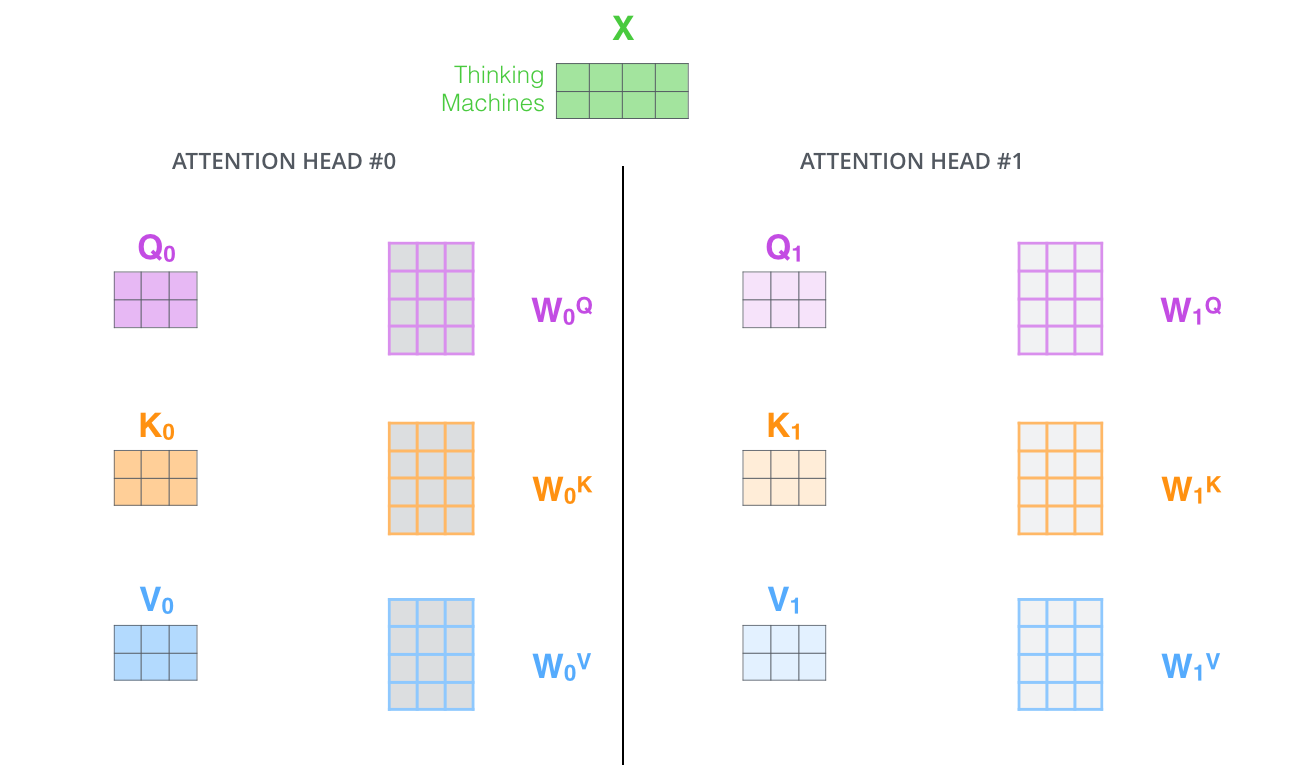
在多头注意力中,网络为每一个头维护独立的Q/K/V权重矩阵,从而得到不同的Q/K/V矩阵.和之前一样,我们将X乘以WQ/WK/WV 矩阵,得到 Q/K/V 矩阵。
如果我们用不同的权重矩阵,将上述相同的自注意力计算执行 8 次,最终会得到 8 个不同的 Z 矩阵。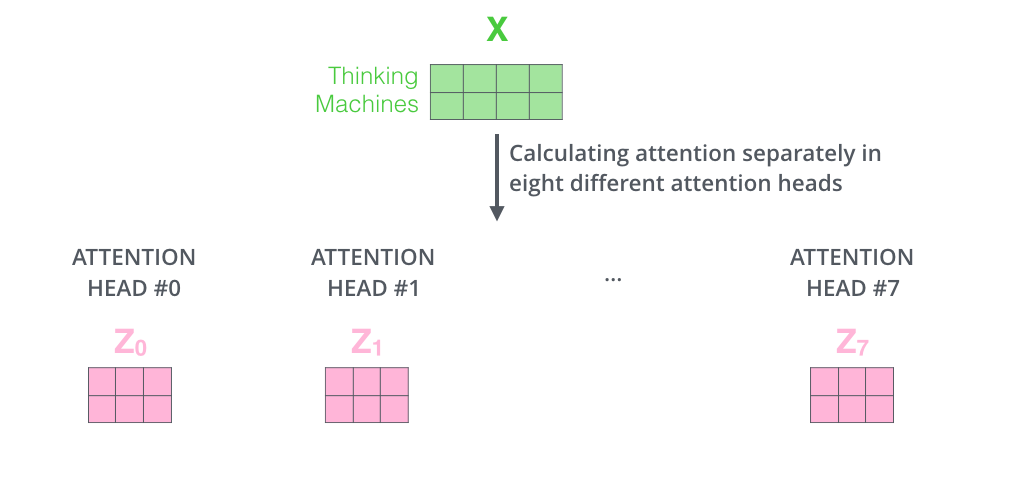
这次带来一个挑战:前馈层并不期望接收8个矩阵,它期望的是接收一个单一局长(每个词对应一个向量).所以我们需要将这8个矩阵压缩成一个矩阵。
怎么做?我们将这些矩阵拼接(concat),然后再乘以一个额外的权重矩阵 WO。
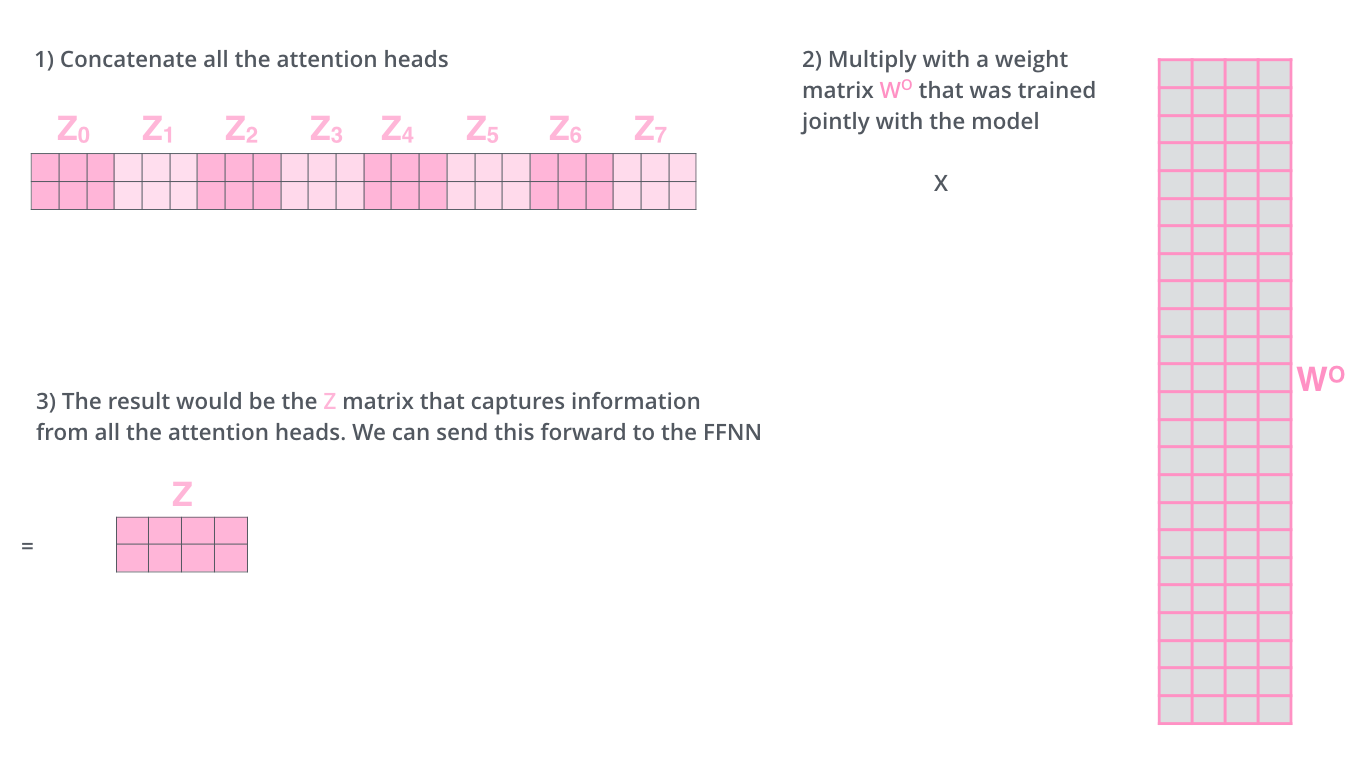
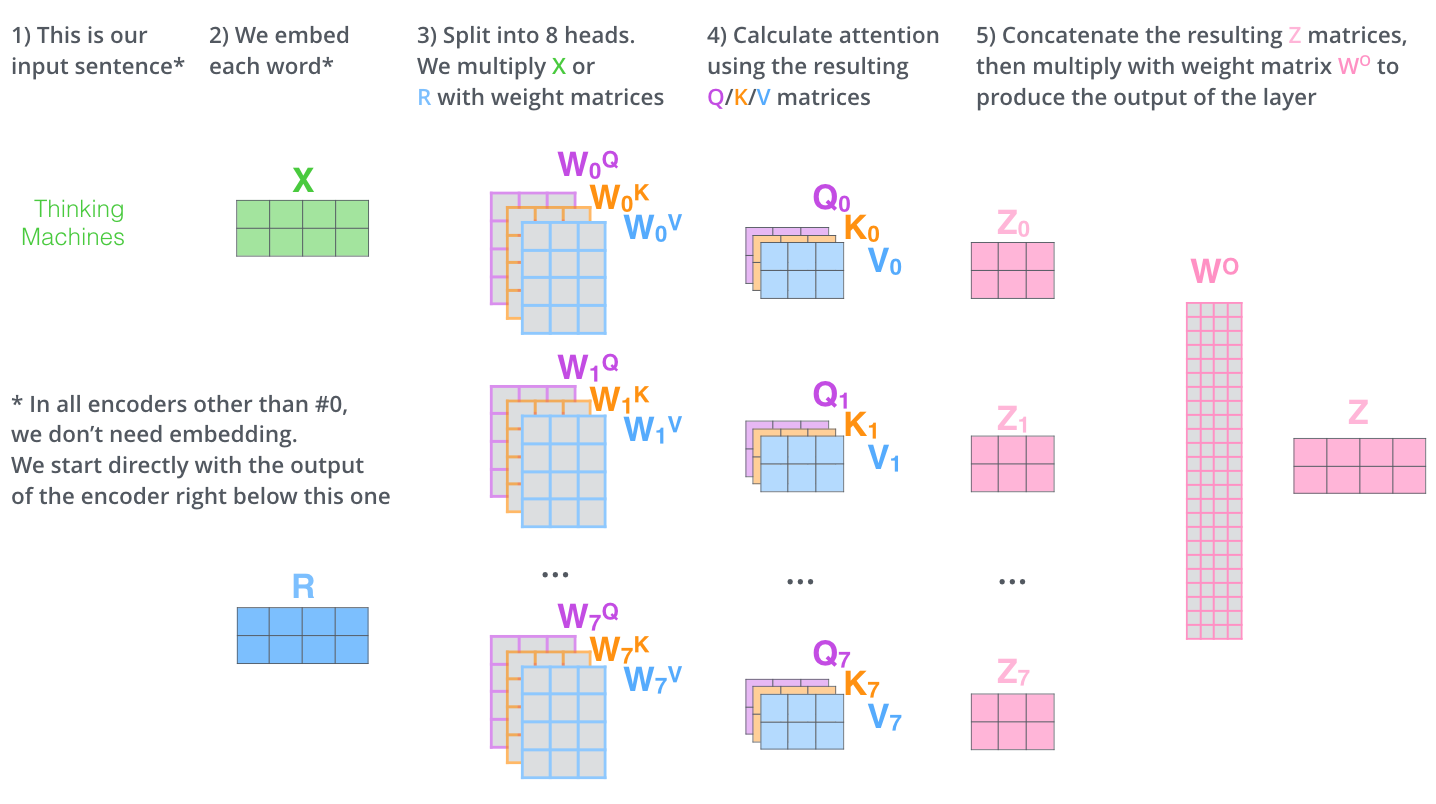
多头自注意力机制大致就是这样。我知道这涉及了相当多的矩阵。让我把它们全部放在一张图里,这样我们可以一览全貌:
现在我们已经接触了注意力头的概念,让我们回到之前的例子,看看在编码示例句子中的 "it" 时,不同的注意力头分别聚焦在哪里:
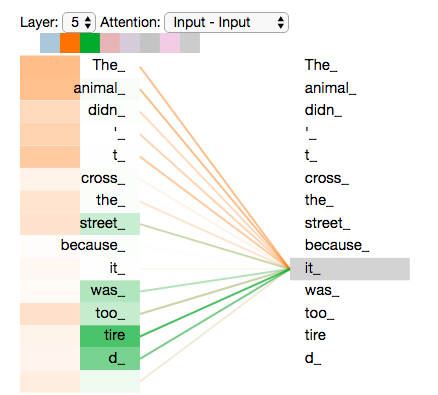
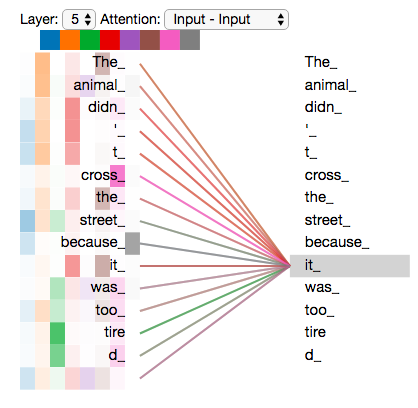
在编码 "it" 时,一个注意力头最关注"the animal",而另一个最关注"tired"——从某种意义上说,模型对 "it" 这个词的表示,融合了 "animal" 和 "tired" 两者的部分表示。
然而,如果我们把所有注意力头都加入图中,事情就会变得更难理解了:
在目前描述的模型中,还缺少一样东西,一种能够感知输入序列中词语顺序的方法。
为了解决这个问题,Transformer在每个输入词嵌入上 叠加一个位置编码向量。 这些向量遵循模型所学习的特定规律,帮助模型确定每个词的位置.或序列中不同词之间的距离。其直觉是:
将这些值加到词嵌入上,在将嵌入向量投影为Q/K/V 向量、进行点积注意力运算时,可以在嵌入向量之间提供有意义的距离信息。
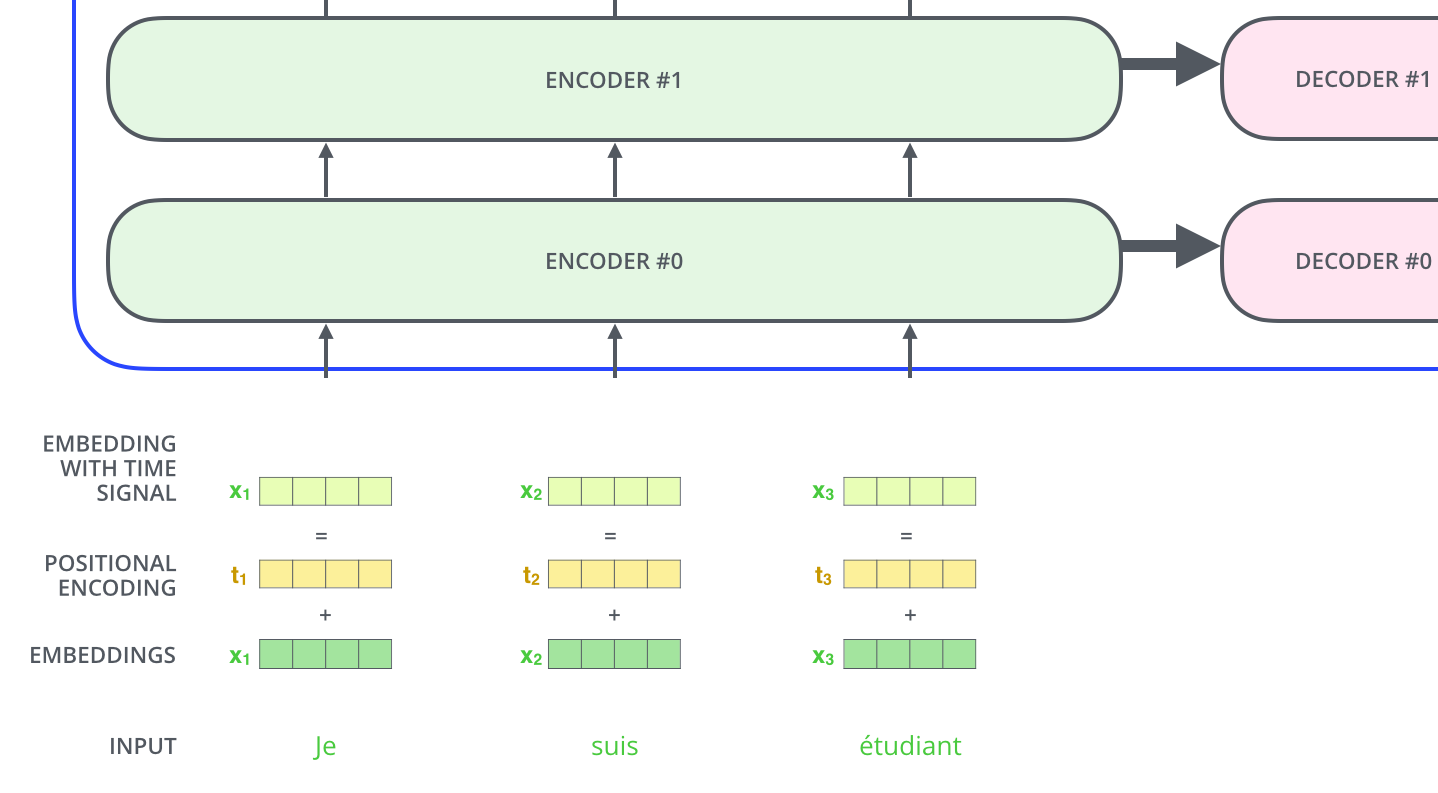
如果假设嵌入维度为 4,实际的位置编码将如下所示:
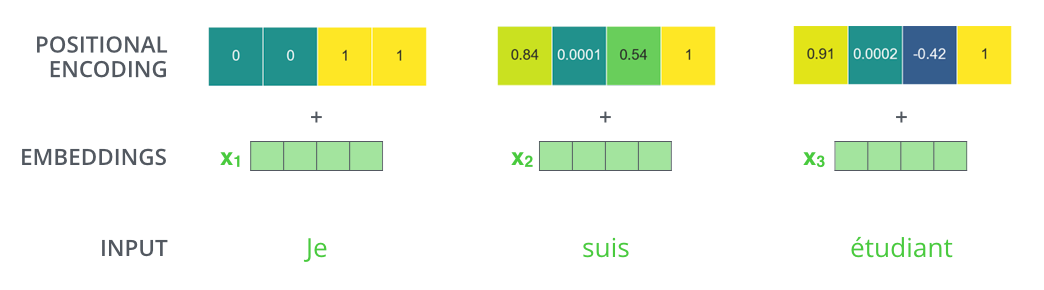
这个规律是什么样的?
在下图中,每一行对应一个向量的位置编码。因此第一行就是我们要加到输入序列第一个词的嵌入上的向量。每行包含 512 个值——每个值在 -1 到 1 之间。我们用颜色编码使规律可见。
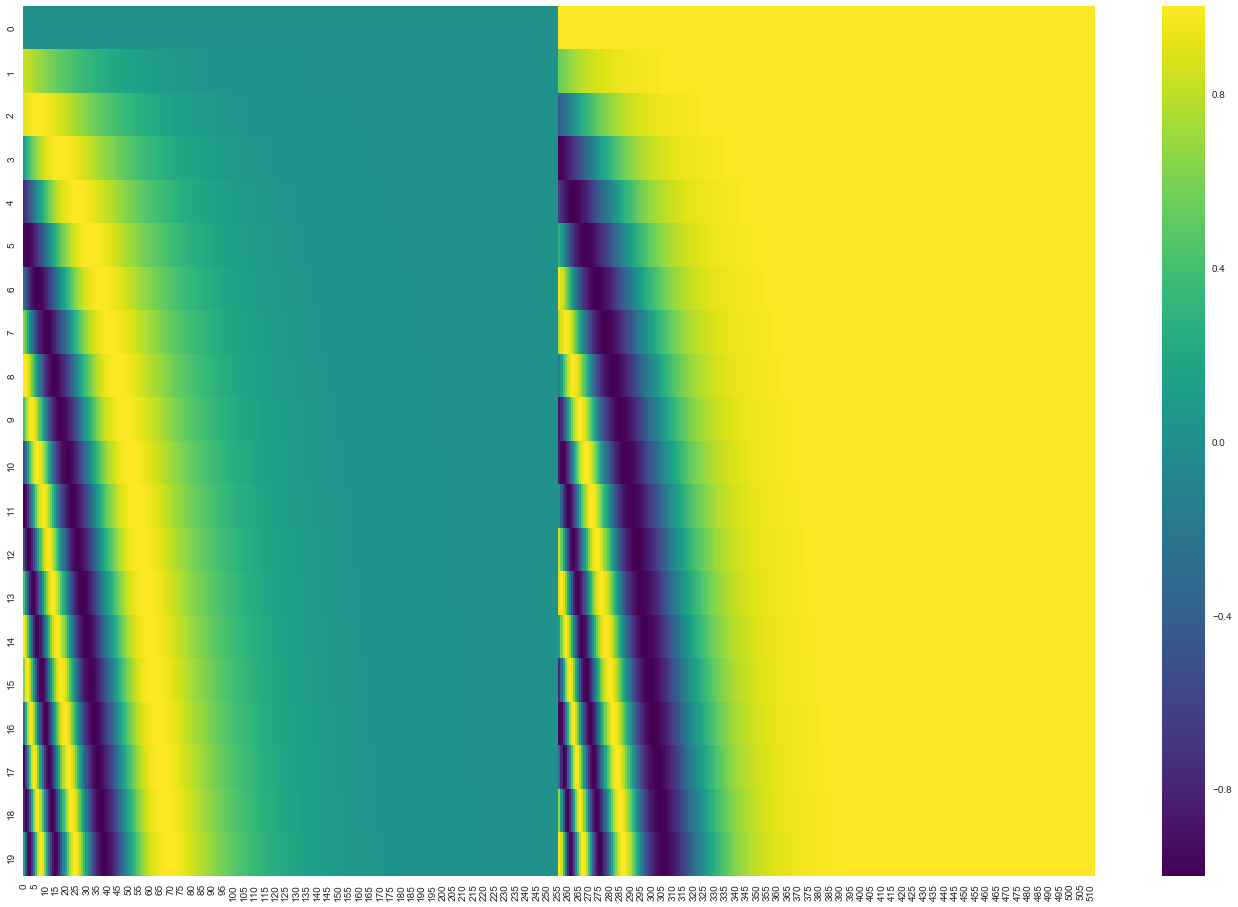
20 个词(行)、嵌入维度为 512(列)的位置编码真实案例。可以看到它在中间被一分为二——因为左半部分的值由一个函数(使用正弦)生成,右半部分由另一个函数(使用余弦)生成。然后将两者拼接,形成每个位置编码向量。
位置编码的公式在论文(第 3.5 节)中有描述。你可以在 get_timing_signal_1d() 中看到生成位置编码的代码。这并不是位置编码的唯一可能方法。然而,它具有能够扩展到未见过的序列长度的优势(例如,如果我们训练过的模型被要求翻译一个比我们训练集中任何句子都长的句子)。
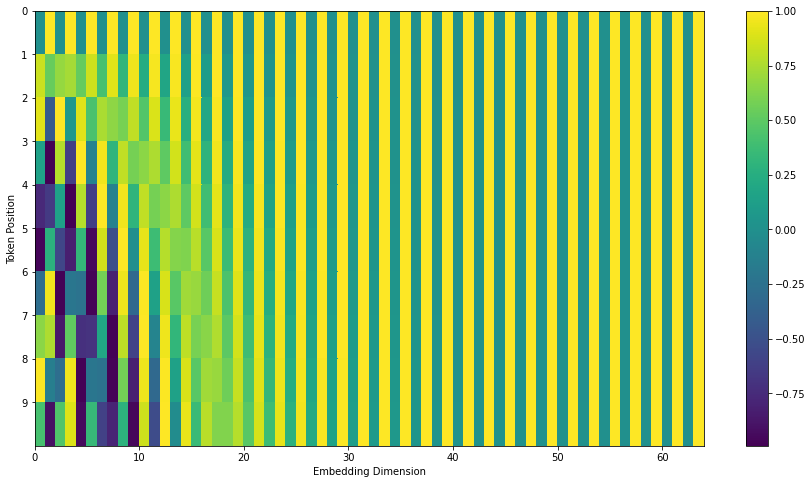
2020 7月更新:上述位置编码来自 Transformer 的 Tensor2Tensor 实现。论文中展示的方法略有不同,因为它不是直接连接,而是交织两个信号。下图展示了其外观。以下是生成它的代码:
残差
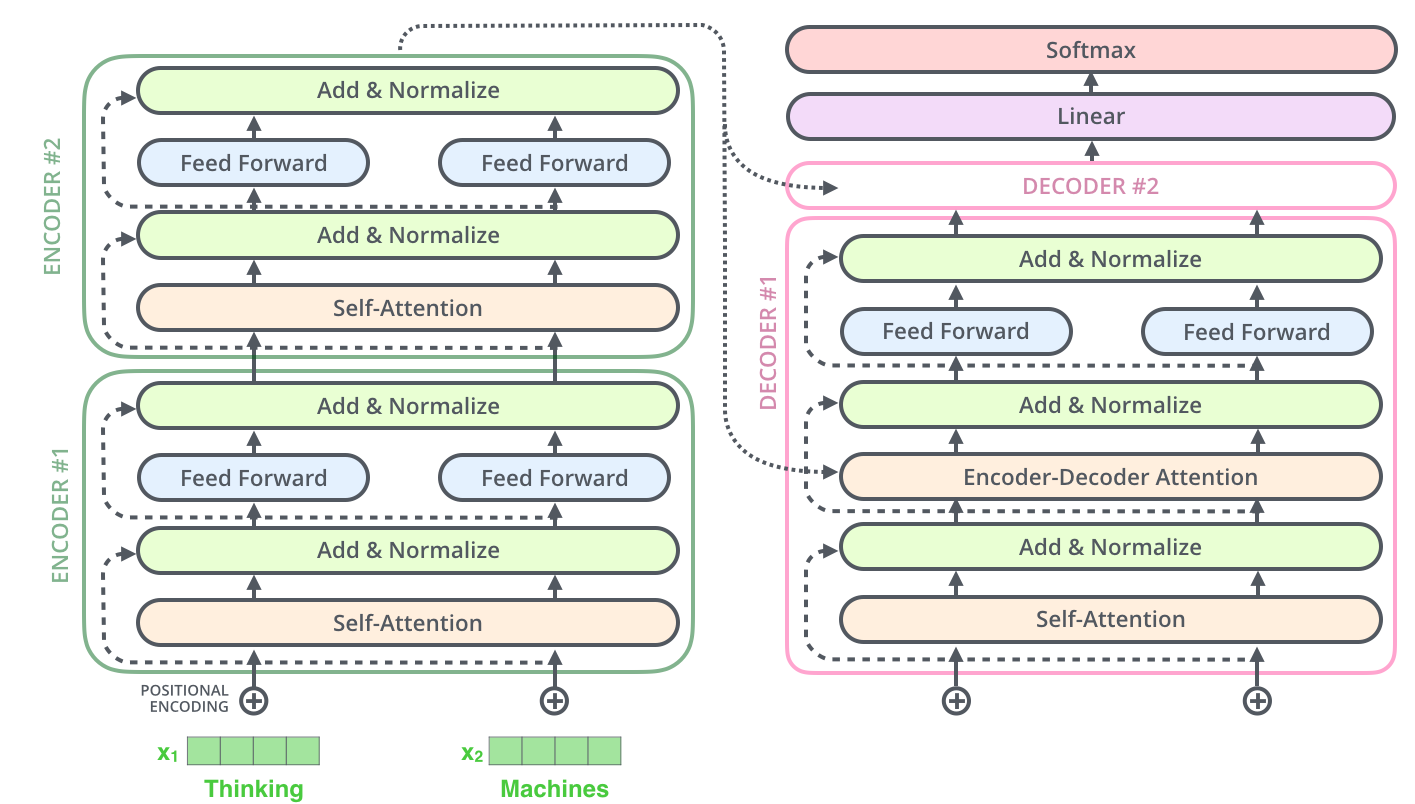
在继续之前,我们需要提到编码器架构中的一个重要细节:每个编码器的每个子层(自注意力层、前馈网络层)周围都有一个残差连接(residual connection),之后跟着一个层归一化(layer-normalization)步骤。
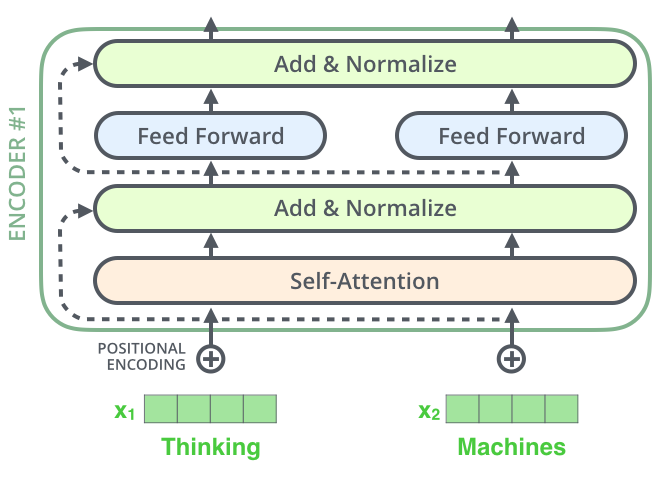
如果我们要可视化与自注意力相关的向量和层归一化操作,它将如下所示:
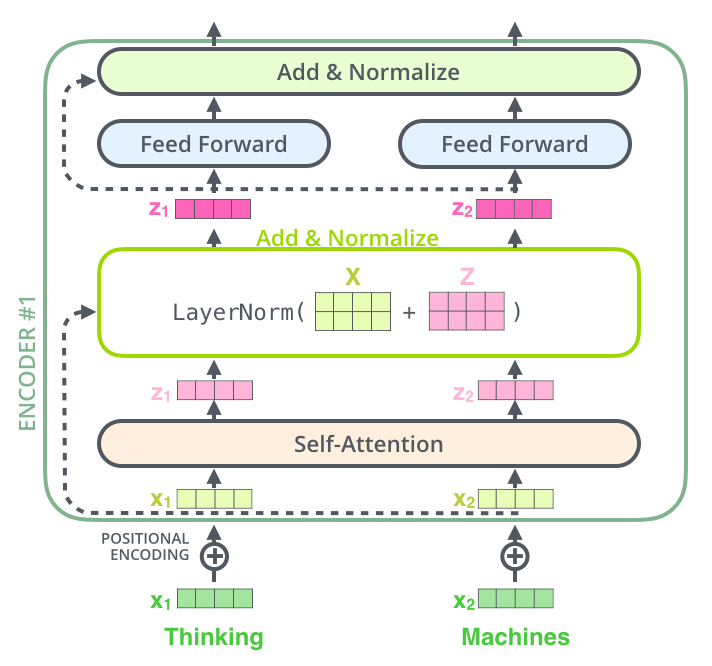
这也适用于解码器的子层。如果我们考虑一个由 2 个堆叠的编码器和解码器组成的 Transformer,它可能会是这样的:
解码端
现在我们已经涵盖了编码器方面的大部分概念,我们基本上也知道了解码器组件是如何工作的,但让我们看看他们是如何协同工作的。
编码器首先处理输入序列。顶层编码器的输出随后被转化为一组注意力向量 K 和 V。这些向量将在每个解码器的"编码器-解码器注意力层"中使用,帮助解码器聚焦于输入序列的适当位置:
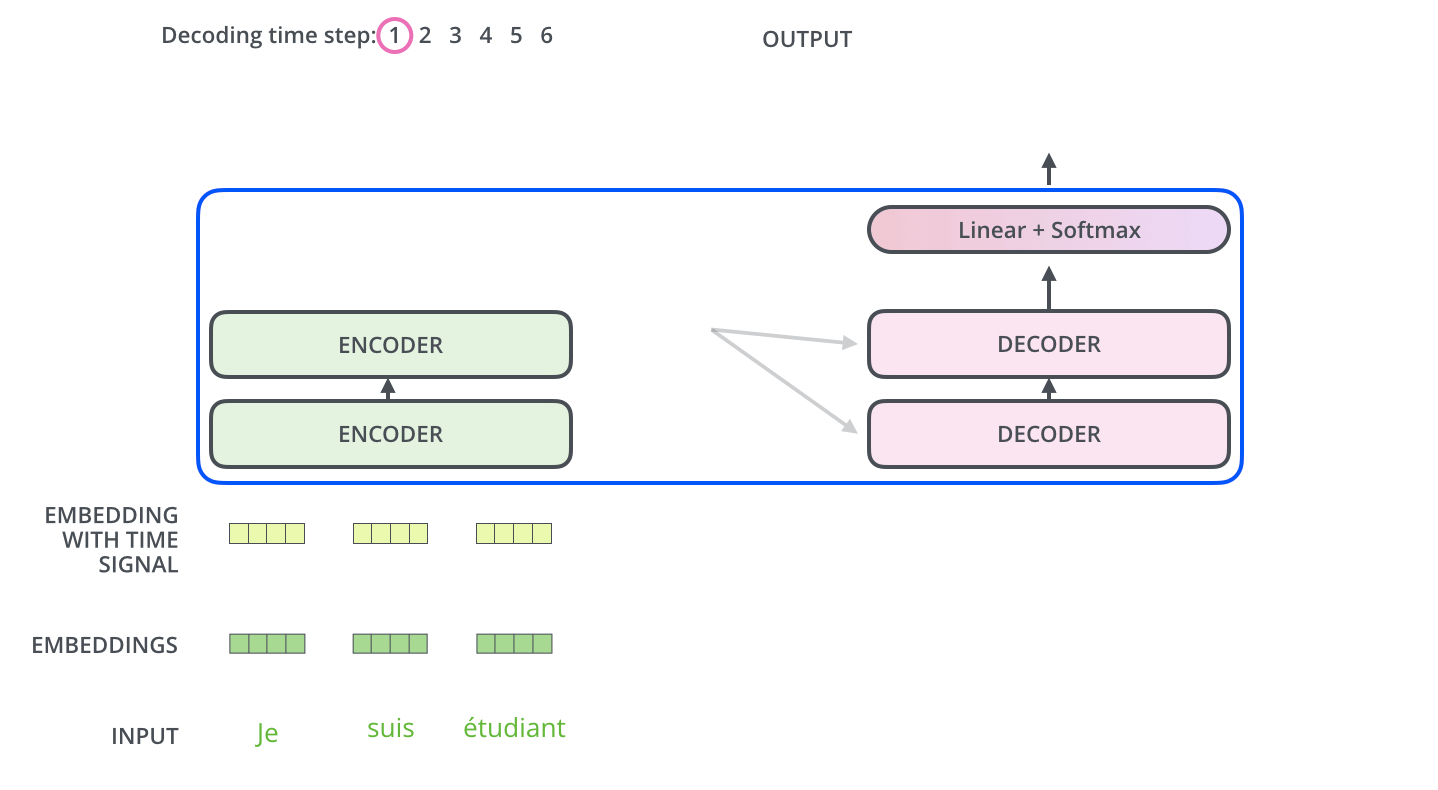
在完成编码阶段后,我们开始解码阶段。解码阶段的每一步都输出输出序列中的一个元素(在这个例子中是英文翻译句子)。
以下步骤重复该过程,直到达到一个特殊符号,表示变压器解码器已完成其输出。每一步的输出都将被馈送到下一个时间步的底部解码器,解码器会像编码器一样向上冒泡它们的解码结果。
就像我们对编码器输入所做的那样,我们对解码器输入进行嵌入并添加位置编码,以指示每个单词的位置。
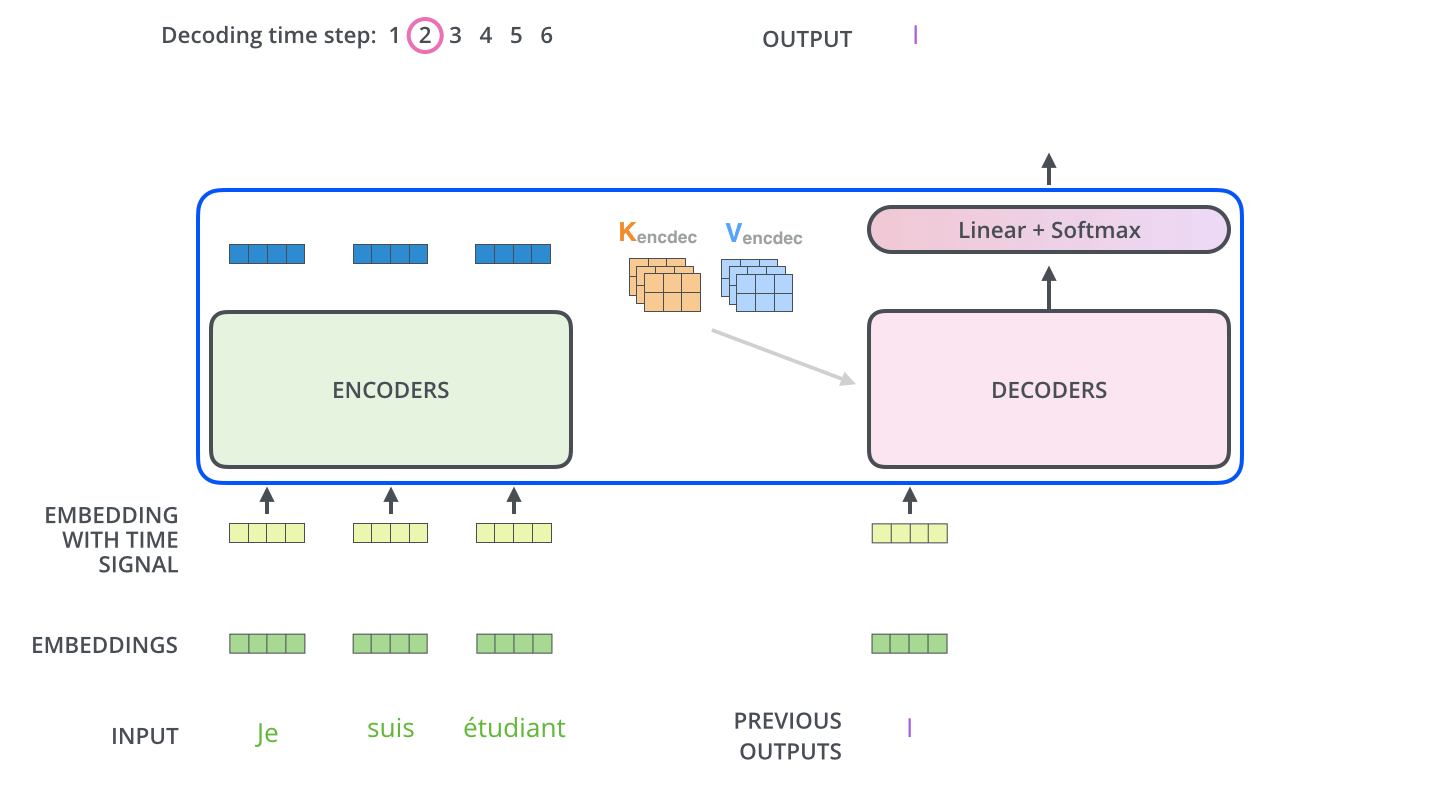
解码器中的自注意力层与编码器中的自注意力层操作方式略有不同:
在解码器中,自注意力层只允许关注输出序列中更早的位置。这是通过在自注意力计算的 softmax 步骤之前屏蔽未来位置(将它们设置为 -inf )来实现的。
“编码器-解码器注意力”层的工作方式与多头自注意力完全相同,只是它从下面的层创建查询矩阵,并从编码器堆栈的输出中获取键和值矩阵。
最终的线性和softmax层
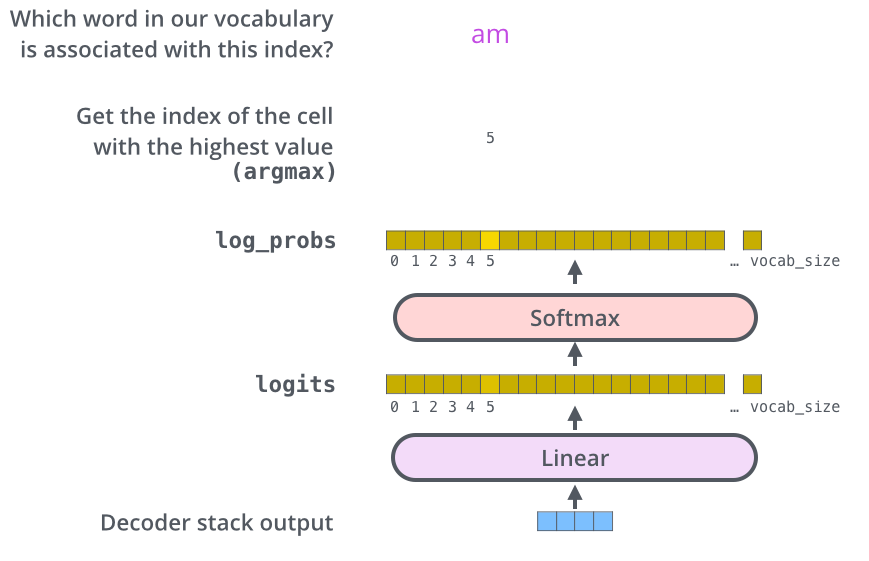
解码器堆栈输出一个浮点数向量。我们如何将该向量转换为单词?这是最终线性层的工作,该层后面跟着一个 Softmax 层。
线性层是一个简单的全连接神经网络,它将解码器堆栈生成的向量投影到一个称为 logits 向量的更大得多的向量中。
假设我们的模型学习了 10,000 个独特的英语词汇(即模型的"输出词汇表")。那么 logits 向量就有 10,000 个格子——每个格子对应一个独特词汇的得分。这就是我们对模型输出经过线性层后的解读方式。
Softmax 层随后将这些得分转化为概率(均为正数,总和为 1.0)。概率最高的格子被选中,其对应的词作为当前时间步的输出。
回顾总结
现在我们已经完整了解了一个训练好的 Transformer 的整个前向传播过程,不妨简要了解一下训练模型的直觉。
在训练期间,未训练的模型会经历完全相同的前向传播过程。但由于我们是在带标注的训练数据集上训练它,我们可以将它的输出与实际的正确输出进行比较。
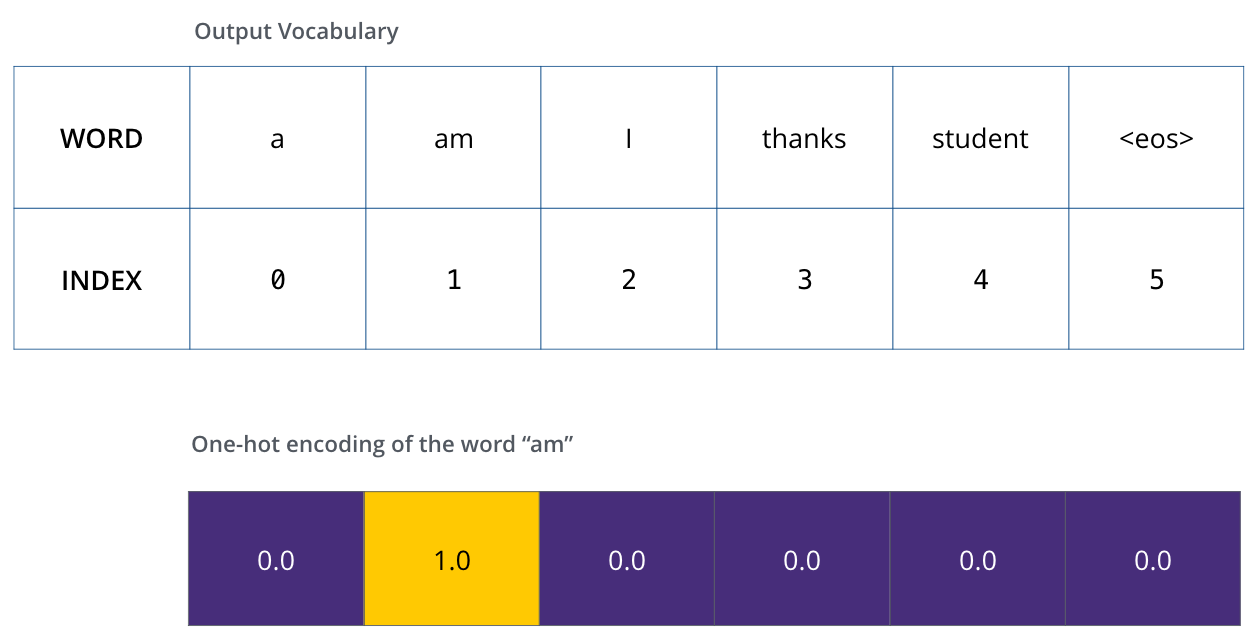
为了可视化这一点,假设我们的输出词汇表只包含六个词:"a"、"am"、"i"、"thanks"、"student",以及 "<eos>"("end of sentence"的缩写,即句子结束符)。
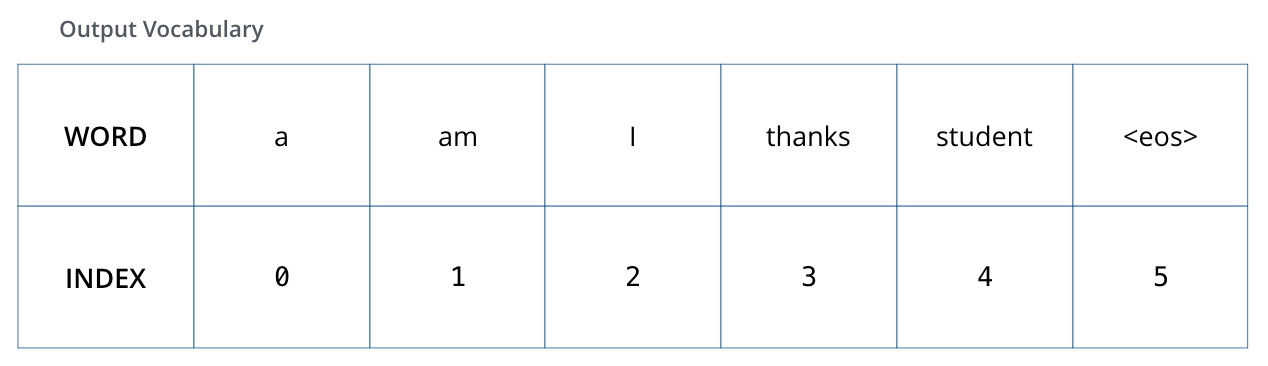
一旦定义了输出词汇表,我们就可以用相同宽度的向量来表示词汇表中的每个词,这也称为 one-hot 编码。例如,我们可以用以下向量表示单词 "am":
在这次回顾之后,让我们讨论模型的损失函数——即训练阶段我们优化的指标,目标是训练出一个希望能非常精确的模型。
损失函数
假设我们正在训练模型,这是训练阶段的第一步,我们用一个简单的例子来训练它——把 "merci" 翻译成 "thanks"。
这意味着我们希望输出是一个指向单词 "thanks" 的概率分布。但由于模型尚未训练,这种情况暂时不太可能发生。
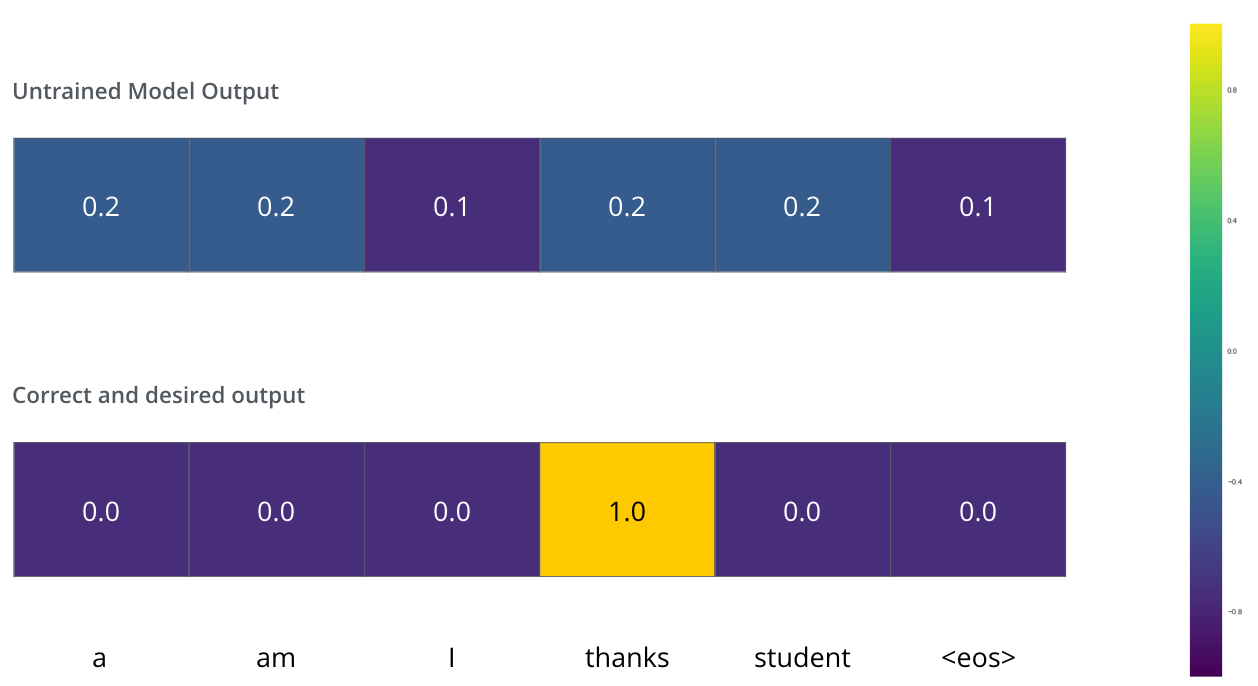
由于模型的参数(权重)都是随机初始化的,(未经训练的)模型对每个格子/词产生的概率分布是任意的。我们可以将其与实际输出进行比较,然后通过反向传播调整所有模型权重,使输出更接近期望输出。
如何比较两个概率分布?我们只需将一个减去另一个。更多细节可以参阅交叉熵(cross-entropy)和 Kullback-Leibler 散度。
但请注意,这是一个过度简化的例子。现实中,我们会使用比一个词更长的句子。例如,输入 "je suis étudiant",期望输出 "i am a student"。这实际上意味着,我们希望模型能依次输出如下概率分布:
每个概率分布都表示为一个宽度为词汇表大小的向量(在我们的玩具例子中是 6,实际中通常是 30,000 或 50,000)
第一个概率分布在与 "i" 对应的格子上有最高概率
第二个概率分布在与 "am" 对应的格子上有最高概率
以此类推,直到第五个输出分布表示
<end of sentence>符号,该符号在 10,000 个元素的词汇表中也有对应的格子
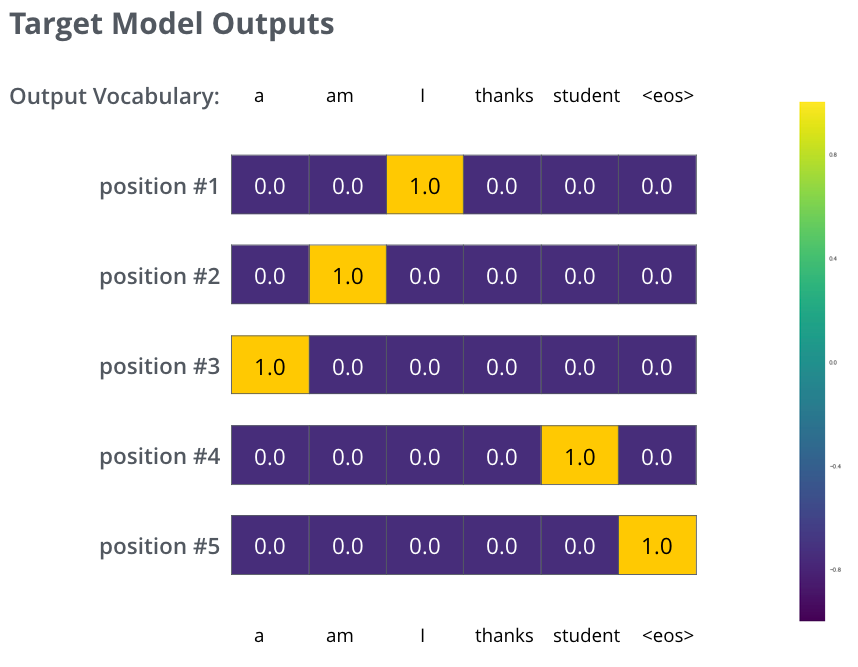
针对一个样例句子的训练示例,我们的模型将以这些目标概率分布来训练。
在足够大的数据集上训练足够长时间之后,我们希望产生的概率分布看起来像这样:
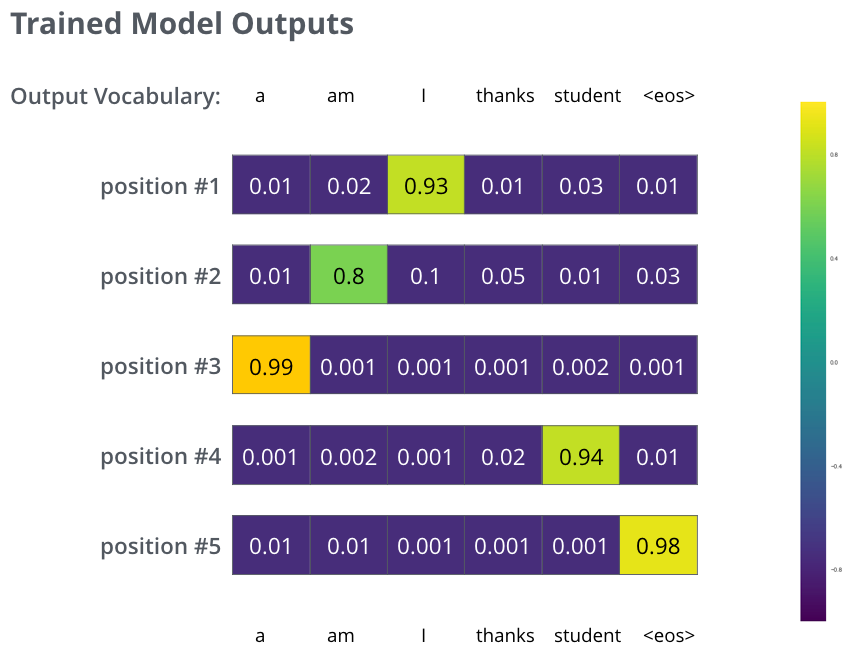
现在,由于模型是逐个生成输出的,我们可以假设模型是从该概率分布中选择概率最高的单词,并丢弃其余的。这是一种方法(称为贪婪解码)。
另一种方法是保留,比如说,前两个词(比如说‘我’和‘一个’),然后在下一步中,运行模型两次:一次假设第一个输出位置是‘我’,另一次假设第一个输出位置是‘一个’,哪个版本在考虑位置#1 和#2 时产生的错误更少,就保留哪个版本。
我们对位置#2 和#3 重复此操作……等等。这种方法被称为“束搜索”,在我们的示例中,束大小为 2(意味着在任何时候,两个部分假设(未完成的翻译)都保存在内存中),并且 top_beams 也是 2(意味着我们将返回两个翻译)。
这些都是您可以进行实验的超参数。
版权声明
本文内容版权归作者或相关权利人所有。转载、引用或其他使用请遵循相应授权条款,并保留本文链接。